 ✍️ 메인 교안 집필: 이영빈 (yblee)
🧑🔬 연구원 리서치 노트 — 작성자: junpark (박준) (
2D Block Tiling 직관)💡 핵심 기여 요약: Nsight Compute의 Roofline 시각화와 CUDA 2D Block Tiling 다이어그램을 연결해 타일 재사용의 기하학적 의미를 정리했습니다.
4주차 정리: Roofline과 Tiling
1. Arithmetic Intensity: 읽어온 데이터로 얼마나 계산하는가
산술 강도(Arithmetic Intensity)는 HBM에서 읽고 쓴 바이트 하나당 몇 번의 연산을 하는지를 나타낸다.
I = 총 FLOPs ÷ HBM에서 읽고 쓴 총 ByteFLOPs가 같아도 HBM에서 옮기는 양이 달라지면 I가 달라지고, 그에 따라 커널이 memory-bound인지 compute-bound인지가 바뀐다. 계산량은 그대로 두고 데이터 이동만 줄여도 커널이 빨라질 수 있다는 뜻이다.
Vector Add와 행렬곱의 가장 큰 차이는 데이터 재사용이다. Vector Add는 각 원소를 딱 한 번만 연산에 쓰기 때문에 아무리 잘 짜도 I가 1/12에서 올라가지 않는다. 반면 C[M, N] = A[M, K] @ B[K, N]에서는 A의 각 원소가 N번, B의 각 원소가 M번 연산에 쓰인다. 같은 데이터를 여러 번 쓸 수 있으니, 한 번 가져온 데이터를 최대한 재사용하면 I를 크게 높일 수 있다. 행렬곱의 총 FLOPs는 C의 원소 MN개마다 곱셈과 덧셈을 K번씩 하므로 2MNK다.
메모리 계층 (H100 SXM 기준, 대략적인 값)
| 계층 | 용량 | 지연시간 (latency) | 대역폭 (칩 전체) |
|---|---|---|---|
| Register | SM당 256KB (전체 약 33MB) | 사실상 ~0–1 cycle | 수백 TB/s |
| Shared memory / L1 | SM당 최대 228KB (L1과 합쳐 256KB) | ~20–30 cycle | 약 30 TB/s |
| L2 cache | 50MB | ~200–270 cycle | 약 5–10 TB/s |
| HBM3 (DRAM) | 80GB | ~400–600+ cycle (수백 ns) | 3.35 TB/s |
연산 장치에 가까울수록 빠르지만 작다. 행렬곱을 단순하게 구현하면 C의 원소 하나를 계산할 때마다 A의 한 행과 B의 한 열을 HBM에서 새로 읽어 오게 된다. 같은 데이터를 수백, 수천 번 HBM에서 다시 가져오는 셈이라, 행렬곱이 본래 가진 재사용 가능성을 전혀 살리지 못하고 I가 Vector Add 수준으로 떨어진다. 그러면 SM은 대부분의 시간을 데이터를 기다리며 보낸다.
하지만 행렬 전체는 온칩 메모리에 들어가지 않는다. 그래서 계산을 작은 조각(타일)으로 나눠, 한 조각을 계산하는 데 필요한 데이터만 온칩 메모리에 올려 두고 그 안에서 여러 번 재사용한다. 이 기법이 tiling이다. GPU에서는 주로 Shared Memory를 프로그래머가 직접 관리하는 캐시(software-managed cache)처럼 써서 타일을 담고, 더 안쪽에서는 레지스터에도 같은 방식을 적용한다(3절).
2. Roofline: 어느 자원이 성능을 제한하는가
산술 강도 I = 총 FLOPs ÷ HBM에서 읽고 쓴 총 Byte
성능 상한 = min(최대 연산 성능 P, HBM 대역폭 BW × I)
두 상한이 만나는 산술 강도(ridge point) = P ÷ BW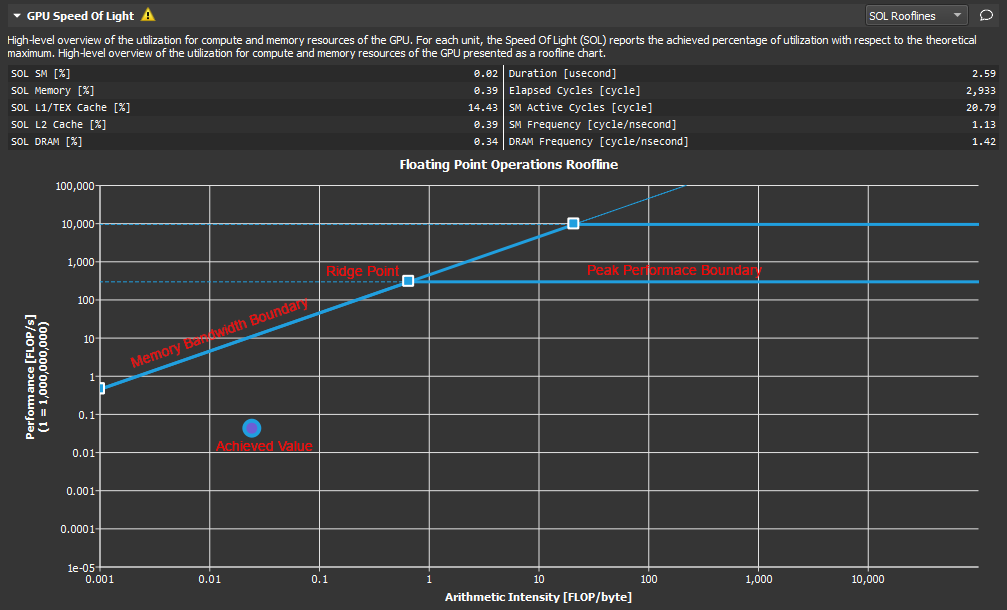
가로축은 산술 강도 I(FLOPs/Byte), 세로축은 시간이 아니라 초당 연산 처리율(FLOPs/s)이다. 두 축 모두 log 스케일을 쓴다.
메모리 대역폭의 한계가 기울어진 선인 이유는, I가 낮은 구간에서는 데이터가 들어오는 속도가 연산 속도를 결정하기 때문이다. 1초에 BW만큼의 바이트가 들어오고 바이트마다 I번 연산할 수 있으니, 낼 수 있는 성능은 BW × I로 I에 비례해 커진다. log-log 그래프에서는 이 비례 관계가 기울기 1의 직선으로 보인다.
반대로 I가 충분히 높으면 데이터는 넉넉히 들어오는데 연산 장치가 따라가지 못한다. 이때는 I를 더 높여도 최대 연산 성능 P를 넘을 수 없으므로 수평선이 된다. 두 선이 만나는 ridge point(P ÷ BW)보다 왼쪽이면 memory-bound, 오른쪽이면 compute-bound다.
이 선들은 주어진 조건에서의 성능 상한이며, 실제 커널이 그 높이까지 도달한다는 뜻은 아니다. Nsight Compute의 Roofline 차트에 찍히는 점은 실제로 측정한 커널의 위치이므로, 점이 지붕에서 얼마나 떨어져 있는지를 보면 개선 여지를 가늠할 수 있다.
3. Tiling: 작은 조각으로 나누면 왜 다시 쓸 수 있는가
C = A @ B에서 A[i][k]는 C[i][j]를 계산할 때 쓰이는데, j가 0부터 N-1까지 모두 해당하므로 C의 i번째 행 전체를 만드는 데 N번 쓰인다. 마찬가지로 B[k][j]는 C의 j번째 열 전체를 만드는 데 M번 쓰인다.
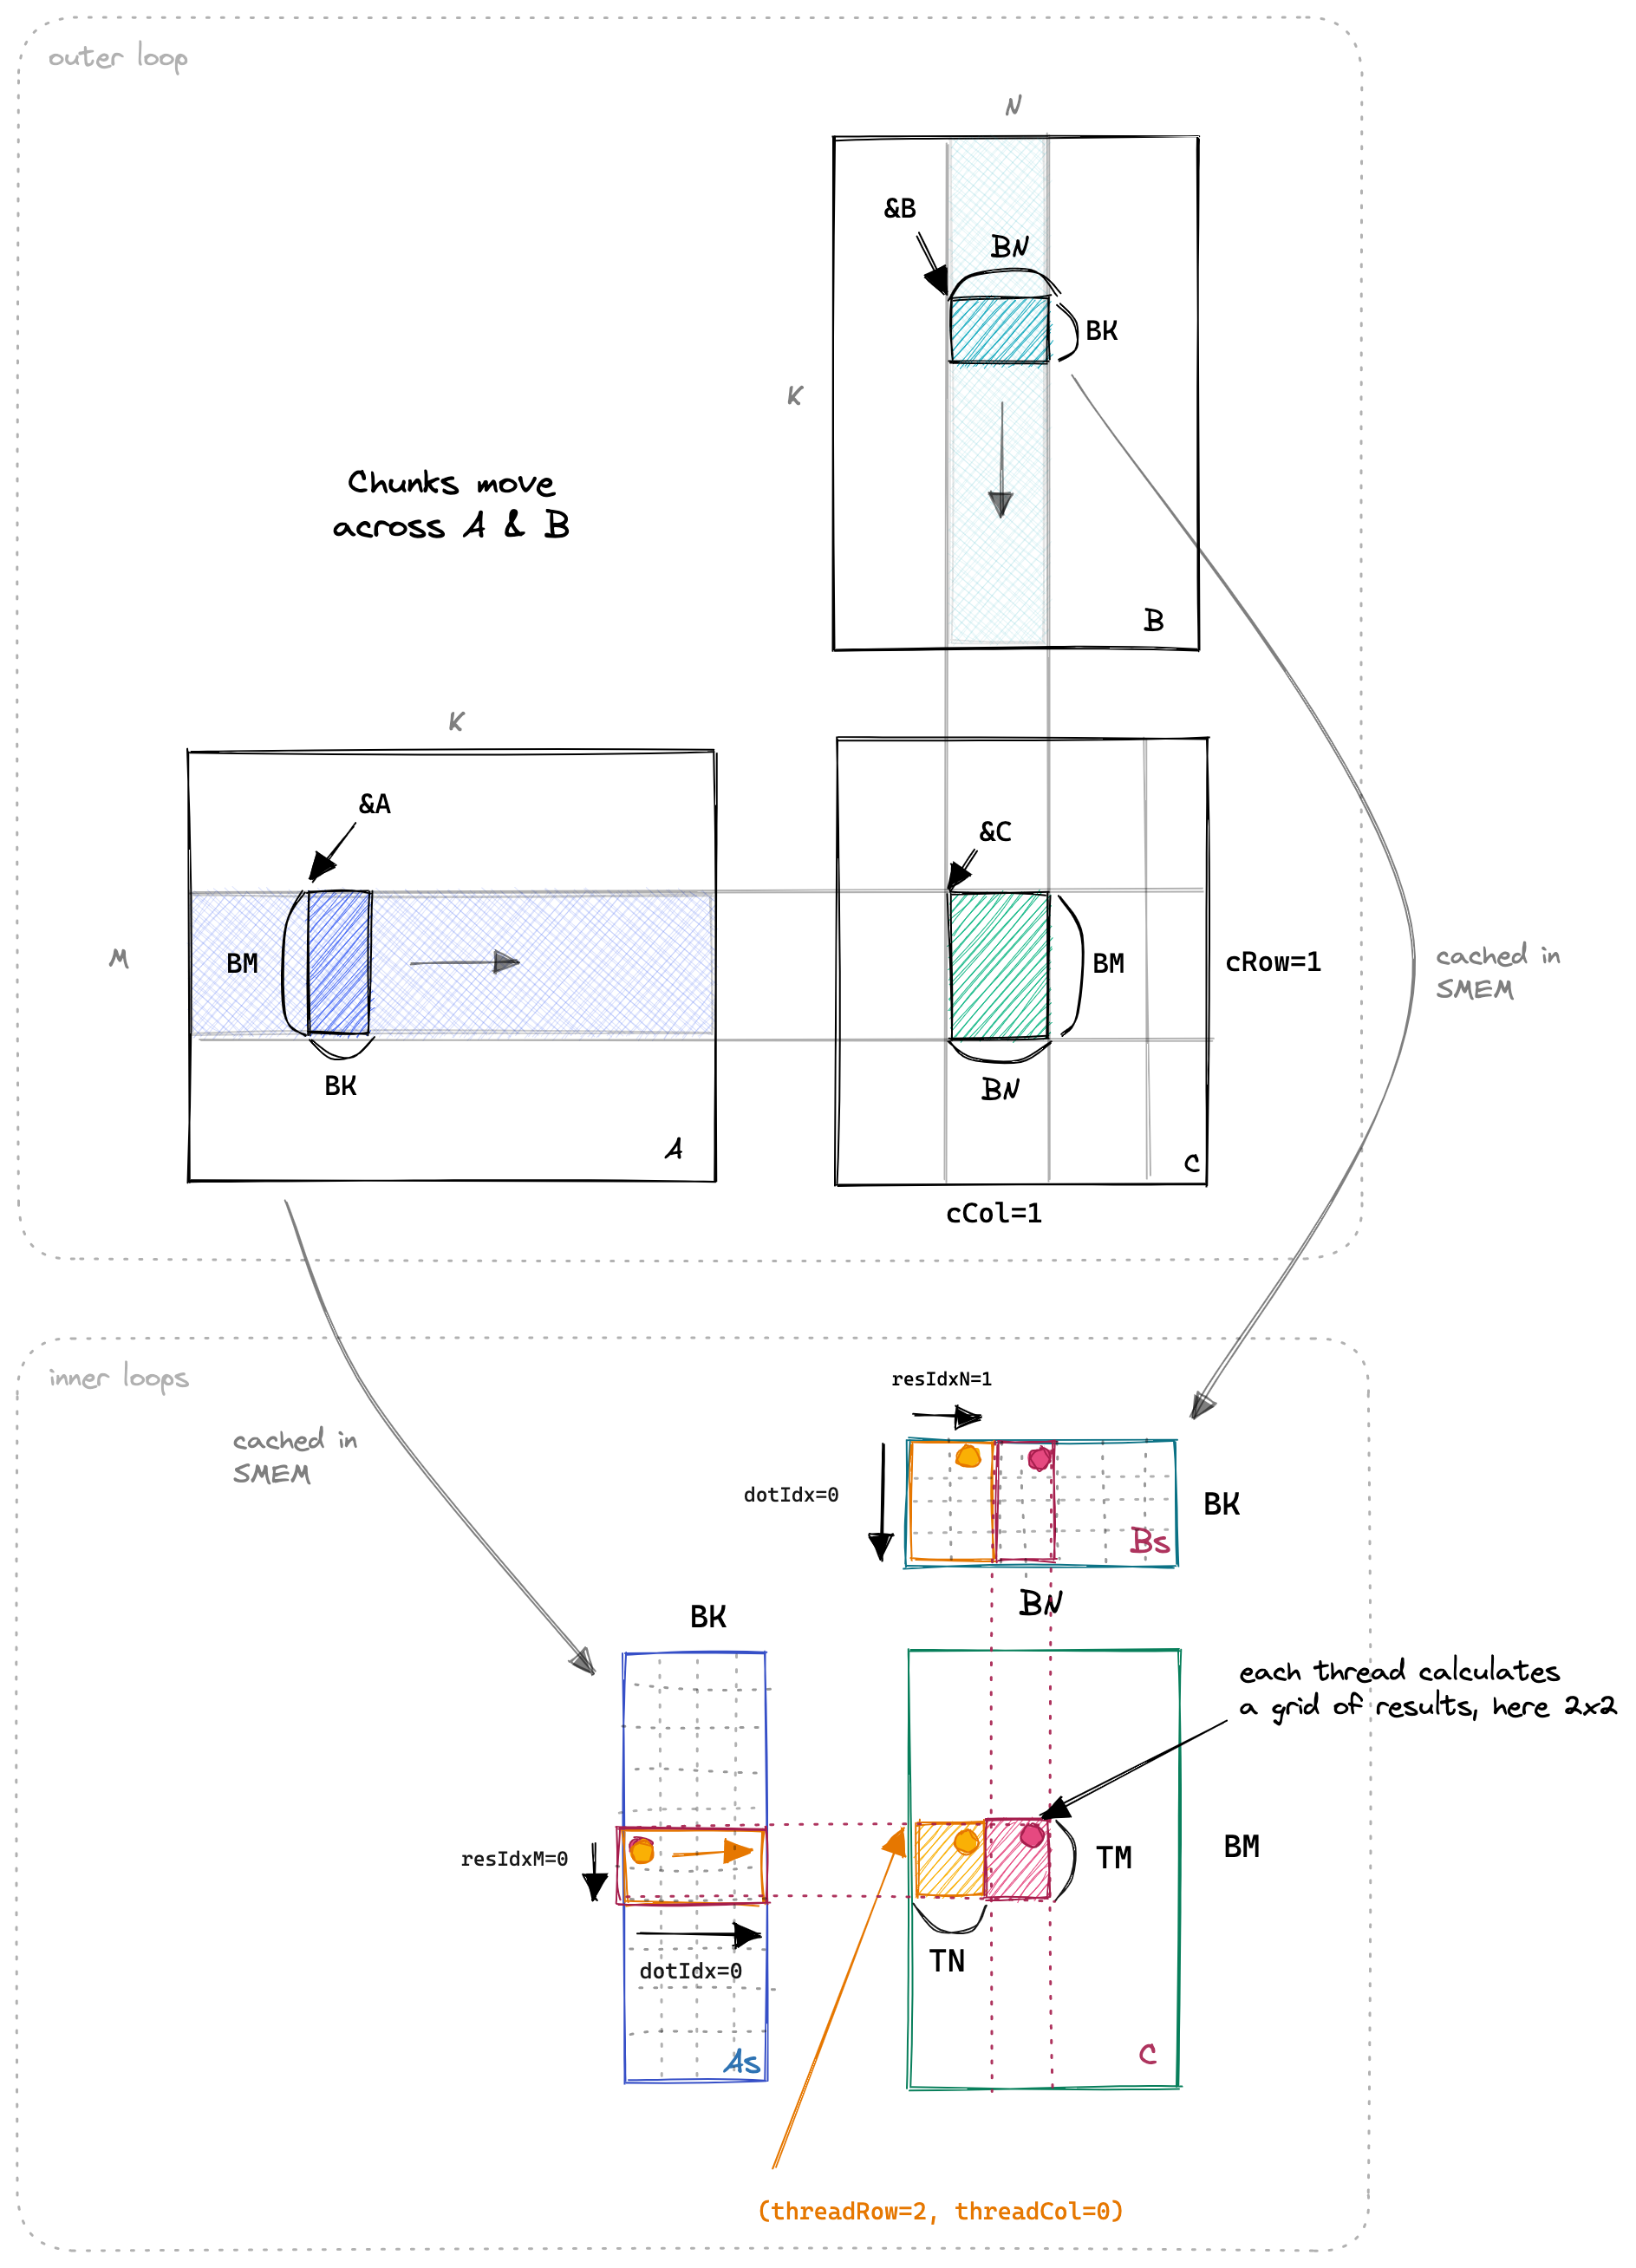
Tiling은 C를 작은 출력 타일로 나누고, 타일 하나를 계산하는 데 필요한 A의 행 묶음과 B의 열 묶음을 K 방향으로 조금씩 잘라 온칩 메모리에 가져온 뒤 재사용하는 방식이다. 연산 횟수는 2MNK로 그대로이고, 줄어드는 것은 HBM 접근 횟수뿐이다. 같은 FLOPs를 더 적은 바이트로 해내므로 I가 올라가고, Roofline 위에서 점이 오른쪽으로 이동한다.
재사용은 두 단계로 일어난다.
Shared memory blocking: 스레드 블록 하나가 출력 타일 하나를 맡는다. 블록 안의 스레드들이 함께 A 타일과 B 타일을 HBM에서 Shared Memory로 가져오고, 그 뒤로는 모든 스레드가 Shared Memory에서 읽어 계산한다. 한 번 가져온 데이터를 블록 안의 여러 스레드가 나눠 쓰는 재사용이며, HBM 이동량을 줄인다.
Local blocking (register blocking): 스레드 하나가 C의 원소 하나가 아니라 작은 블록(예: 8×8)을 맡는다. 매 k 단계마다 A 값 8개와 B 값 8개를 레지스터로 가져와 8 × 8 = 64번의 곱셈·덧셈에 재사용한다. 스레드 안에서의 재사용이며, Shared Memory 접근량을 줄인다.
즉 HBM → Shared Memory 구간은 블록 단위 타일로, Shared Memory → 레지스터 구간은 스레드 단위 타일로 재사용을 만든다.
4. 타일 크기: 크게 만들수록 좋은가
타일을 키우면 산술 강도가 올라가지만(5절 계산 참고), 큰 타일에는 대가가 있다. 출력 타일이 커지면 Shared Memory에 올려야 할 A·B 조각이 커지고, 각 스레드가 레지스터에 들고 있어야 할 중간 합(누적값)도 많아진다. 그런데 스레드당 레지스터는 최대 255개이고, SM 하나의 레지스터 파일(256KB)과 Shared Memory(최대 228KB)도 정해져 있다.
블록 하나가 자원을 많이 쓰면 SM 하나에 동시에 올릴 수 있는 블록 수가 줄어든다. 이 정도를 나타내는 지표가 occupancy다.
Occupancy = SM에 실제로 상주(resident)하는 warp 수 ÷ SM이 담을 수 있는 최대 warp 수상주하는 warp가 많아야 한 warp가 HBM 데이터를 기다리는(1절 표의 수백 cycle 지연시간) 동안 다른 warp가 계산을 이어 가며 지연시간을 숨길 수 있다. 그래서 타일 크기는 재사용(I를 높임)과 occupancy(지연시간을 숨김) 사이의 균형으로 정해진다. 다만 행렬곱처럼 스레드마다 레지스터 타일로 할 일이 많은 커널은 occupancy가 낮아도 한 스레드 안에서 독립적인 연산을 겹쳐 실행해 지연시간을 숨길 수 있어서, occupancy가 낮다고 항상 나쁜 것은 아니다.
하드웨어가 잘 처리하는 크기에 맞추는 것도 중요하다. Tensor Core는 정해진 모양(예: m16n8k16)의 행렬 조각 단위로 곱셈을 하고, Hopper의 TMA(Tensor Memory Accelerator)는 HBM에서 Shared Memory로 타일을 비동기로 옮겨 주는데 정렬과 크기 조건이 있다. 그래서 타일 크기는 보통 이 단위들의 배수로 고른다.
출력 타일 크기 ≠ 스레드 수
출력 타일의 크기와 스레드 수는 같은 개념이 아니다. 예를 들어 128 × 128 출력 타일(원소 16,384개)을 스레드 256개가 계산하면, 스레드 하나가 8 × 8 = 64개의 출력을 맡는다. 3절의 local blocking이 바로 이것이다. 지난주 Triton Vector Add에서 BLOCK_SIZE = 512를 num_warps = 4(128 스레드)가 나눠 맡아 스레드당 4개씩 처리했던 것과 같은 구조다.
Nsight Compute의 Occupancy 섹션 읽기
아래는 RTX 5090(Blackwell)에서 측정한 결과다. 1절 표의 H100과는 다른 GPU라 SM당 최대 warp 수 같은 한계값이 다르다.
Section: Occupancy
------------------------------- ----------- ------------
Metric Name                     Metric Unit Metric Value
------------------------------- ----------- ------------
Max Active Clusters                 cluster            0
Max Cluster Size                      block            8
Overall GPU Occupancy                     %            0
Cluster Occupancy                         %            0
Block Limit Barriers                  block           24
Block Limit SM                        block           24
Block Limit Registers                 block            2
Block Limit Shared Mem                block            2
Block Limit Warps                     block           12
Theoretical Active Warps per SM        warp            8
Theoretical Occupancy                     %        16.67
Achieved Occupancy                        %         8.33
Achieved Active Warps Per SM           warp         4.00
------------------------------- ----------- ------------
Block Limit 항목들은 각 자원 기준으로 SM 하나에 블록을 몇 개까지 올릴 수 있는지를 보여 주고, 그중 가장 작은 값이 실제 한계가 된다. 여기서는 레지스터와 Shared Memory가 둘 다 2블록으로 가장 빡빡하다. 큰 타일을 쓰느라 두 자원을 많이 쓴 결과다.
블록 하나가 4 warp(128 스레드)이므로(Block Limit Warps 12 = 48 ÷ 4) 2블록이면 8 warp가 상주할 수 있고, RTX 5090의 SM당 최대 warp가 48개라 이론 occupancy는 8 ÷ 48 = 16.67%다. 실제 측정값(Achieved)은 4 warp, 8.33%로 이론값의 절반인데, 그리드의 블록 수가 적어 모든 SM을 꽉 채우지 못했거나 실행 끝부분에서 일부 SM이 놀았을 가능성이 있다.
5. 행렬곱의 데이터 재사용 손계산
작은 예: 4×4 행렬곱을 2×2 출력 타일로
M = N = K = 4이고, 출력 타일을 2×2, K 방향 조각의 폭도 2로 둔다. 출력 타일 C[0:2, 0:2] 하나를 계산하는 과정은 이렇다.
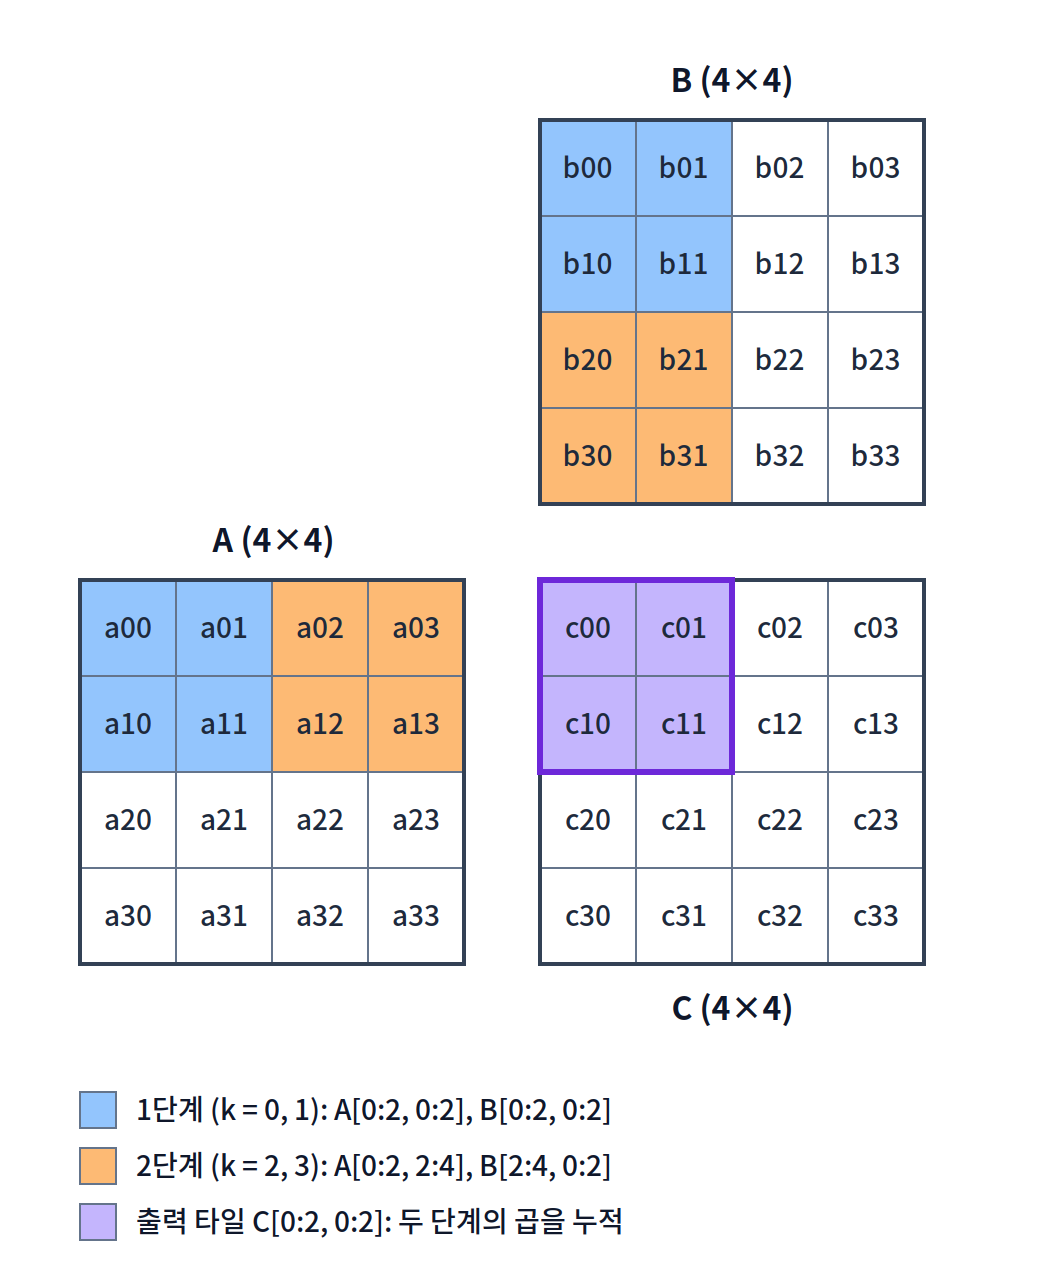
출력 타일 C[0:2, 0:2](보라색)는 K 방향을 두 단계로 나눠 계산한다. 1단계(파란색)에서는 A[0:2, 0:2]와 B[0:2, 0:2]를, 2단계(주황색)에서는 A[0:2, 2:4]와 B[2:4, 0:2]를 가져온다. 단계마다 A 4개 + B 4개 = 8개를 읽어 C 타일 4개 원소에 누적한다.
a00은 한 번 읽어서 c00과 c01 두 출력의 계산에 쓰인다. 마찬가지로 b00은 c00과 c10에 쓰인다. 즉 읽어 온 입력 하나를 타일 안에서 출력 2개에 재사용한다.
| 방식 | HBM에서 읽는 A·B 원소 수 | 입력 하나가 쓰이는 출력 수 |
|---|---|---|
| 재사용 없음 | 출력 16개 × (4 + 4) = 128 | 1 |
| 2×2 타일 | 타일 4개 × 2단계 × 8 = 64 | 2 |
| 전부 온칩 (이상적) | 16 + 16 = 32 | 4 |
FLOPs는 세 경우 모두 2 × 4 × 4 × 4 = 128로 같고, 읽는 양만 달라진다. 여기에 최종 C 16개를 한 번 쓰는 64 B를 더하면 총 이동량은 재사용 없음 512 + 64 = 576 B, 2×2 타일 256 + 64 = 320 B이고, I는 128/576 = 2/9 ≈ 0.22에서 128/320 = 0.4로 오른다. 읽기는 절반이 되지만 C 쓰기는 그대로라 총 이동량이 정확히 절반이 되지는 않는다.
일반 공식: 타일 단위로 세어 보기
블록 하나가 맡는 출력 타일을 BM × BN, K 방향으로 한 번에 가져오는 조각의 폭을 BK로 둔다. 출력 타일 하나는 K / BK 단계에 걸쳐, 매 단계 A 조각(BM × BK)과 B 조각(BK × BN)을 곱해 누적한다.
연산량과 HBM 이동량을 같은 방식으로 세어 보면 다음과 같다.
| 한 단계 | 타일 하나 (× K/BK 단계) | 전체 (× (M/BM)(N/BN) 타일) | |
|---|---|---|---|
| FLOPs | 2 · BM · BN · BK | 2 · BM · BN · K | 2MNK |
| HBM 읽기 (원소) | BM · BK + BK · BN | K · (BM + BN) | MNK · (1/BM + 1/BN) |
| HBM 쓰기 (원소) | - | BM · BN | MN |
한 단계에서는 C 타일의 BM × BN개 원소마다 BK번씩 곱셈과 덧셈을 하므로 2 · BM · BN · BK FLOPs다. 이를 단계 수와 타일 수만큼 곱하면 BM, BN, BK가 모두 약분되어 2MNK가 된다. 즉 타일을 어떻게 나누든 전체 연산량은 타일링 전과 같다. 타일링은 같은 곱셈·덧셈을 다른 순서로 묶어서 할 뿐이다.
반면 HBM 읽기에는 1/BM + 1/BN이 남는다. 타일이 클수록 가져온 조각을 더 많은 출력에 재사용하므로 읽는 양이 줄어든다. 여기에 C를 한 번 쓰는 MN 원소를 더하면 다음과 같다.
HBM 이동량 = 4B × [MNK × (1/BM + 1/BN) + MN]
산술 강도 I = 2MNK ÷ HBM 이동량 ≈ BM·BN / (2(BM + BN))   (C 쓰기 무시)
BM = BN = T이면 HBM 읽기는 8MNK / T 바이트, I ≈ T / 4다. 또 BK는 FLOPs와 이동량 양쪽에서 모두 사라진다. BK는 한 번에 Shared Memory에 올려 두는 버퍼 크기만 정한다.
앞의 4×4 예에 대입하면 한 단계 2 · 2 · 2 · 2 = 16 FLOPs, 타일 하나 2단계로 32 FLOPs, 타일 4개로 128 FLOPs가 되어 2 · 4³ = 128과 같다.
4096 × 4096 FP32 행렬곱
A, B, C가 모두 4096 × 4096 FP32 행렬이고, 가상 하드웨어는 P = 20 × 10¹² FLOPs/s, BW = 1 × 10¹² B/s(ridge point 20 FLOPs/B)다. 입력은 이미 장치에 있고, 중간 합은 온칩에 유지하며 최종 C만 한 번 쓴다. 기존 C는 읽지 않고, 서로 다른 출력 타일 사이의 캐시 재사용은 없다고 가정한다. 타일은 BM = BN = BK = T로 둔다.
FLOPs는 모든 경우 2 × 4096³ ≈ 1.37 × 10¹¹로 같고, 연산 시간은 약 6.87 ms다. C 쓰기는 4 × 4096² ≈ 0.067 GB로 모든 경우에 포함했다. 여기서 1 GB = 10⁹ B이므로, BW = 1 TB/s에서는 이동량의 GB 숫자가 곧 메모리 시간의 ms 숫자가 된다.
| 방식 | HBM 이동량 | I (FLOPs/B) | 성능 상한 | 이상적 실행시간 | 병목 |
|---|---|---|---|---|---|
| 재사용 없음 | 약 550 GB | 0.25 | 0.25 TFLOPs/s | 약 550 ms | memory |
| T = 32 | 약 17.2 GB | 약 7.97 | 약 7.97 TFLOPs/s | 약 17.2 ms | memory |
| T = 64 | 약 8.66 GB | 약 15.9 | 약 15.9 TFLOPs/s | 약 8.66 ms | memory |
| T = 128 | 약 4.36 GB | 약 31.5 | 20 TFLOPs/s (P) | 약 6.87 ms | compute |
| (참고) 각 원소 1번씩 | 약 0.20 GB | 약 683 | 20 TFLOPs/s (P) | 약 6.87 ms | compute |
성능 상한은 min(P, BW × I)이고, 이상적 실행시간은 FLOPs ÷ 성능 상한, 즉 max(연산 시간, 메모리 시간)과 같다. T를 두 배로 키울 때마다 입력 읽기는 정확히 절반이 되지만, 변하지 않는 C 쓰기(0.067 GB) 때문에 총 이동량은 거의 절반, I는 거의 두 배가 된다(그래서 I가 T/4 = 8, 16, 32보다 조금 작다). 이렇게 Roofline의 기울어진 선을 타고 올라가다가, I가 ridge point 20을 넘는 T = 128에서 수평선에 닿는다. 그 이후로는 타일을 더 키워도 더 빨라지지 않는다.
필요한 온칩 메모리
같은 조건에서 타일 하나를 계산하는 데 필요한 온칩 공간은 이렇다(FP32, 1 KB = 1024 B).
| T | 입력 버퍼 (A 조각 + B 조각) | 중간 합 (C 타일) | 합계 |
|---|---|---|---|
| 32 | 2 × 32² × 4B = 8 KB | 32² × 4B = 4 KB | 12 KB |
| 64 | 32 KB | 16 KB | 48 KB |
| 128 | 128 KB | 64 KB | 192 KB |
T를 두 배로 키우면 이득(I)은 두 배지만 비용(온칩 메모리)은 네 배가 된다. 입력 버퍼를 Shared Memory에, 중간 합을 레지스터에 둔다고 하면 T = 128에서는 입력 버퍼만 128 KB라 H100의 SM당 Shared Memory(최대 228 KB)에 블록이 하나밖에 못 올라간다. 중간 합 64 KB는 32비트 레지스터 16,384개이므로, 256 스레드가 나눠 가져도 스레드당 64개가 누적값에만 쓰인다. 여기에 다음 조각을 미리 불러오는 double buffering까지 하면 입력 버퍼가 두 배(256 KB)가 되어 아예 들어가지 않는다. 4절에서 본 occupancy 문제가 바로 여기서 생긴다.
앞에서 본 것처럼 BK는 이동량에 영향을 주지 않으므로, 실제 커널은 BM, BN은 크게 두고 BK만 작게 잡는 경우가 많다. 예를 들어 BM = BN = 128, BK = 32로 두면 I는 T = 128일 때와 같은 약 31.5를 유지하면서, 입력 버퍼는 (128 × 32 + 32 × 128) × 4B = 32 KB로 1/4이 된다. Triton 행렬곱 튜토리얼의 BLOCK_SIZE_M, BLOCK_SIZE_N, BLOCK_SIZE_K가 각각 BM, BN, BK다.
Triton에서 3절의 두 단계를 나눠 맡는 방식은 이렇다. 사용자는 블록 타일(BM, BN, BK)과 num_warps, num_stages만 정하고, 실제 Shared Memory 배치는 컴파일러가 한다. tl.load한 조각이 tl.dot의 입력이면 컴파일러가 Shared Memory에 올리고, num_stages에 맞춰 다음 K 조각을 미리 가져오는 double buffering도 넣어 준다. CUDA처럼 __shared__ 버퍼와 __syncthreads()를 직접 쓰지 않는다. tl.dot은 Tensor Core 명령(mma, Hopper에서는 wgmma)으로 바뀌고, 블록 타일을 warp와 스레드에 어떻게 나눌지도 컴파일러가 정한다. 이때 local blocking의 재사용 단위는 3절의 "스레드 하나가 8×8"이 아니라 warp 단위의 행렬 조각(예: m16n8k16)이고, 누적값은 warp 안 스레드들의 레지스터에 나뉘어 들어간다.
이 계산은 실제 제품의 측정값을 예측하기 위한 것이 아니라, 재사용 효과만 분리해서 보기 위한 단순화다. 실제로는 L2 캐시가 출력 타일 사이의 재사용 일부를 잡아 주기 때문에, 재사용 없는 구현도 550 ms보다는 빠르게 측정된다.