 ✍️ 메인 교안 집필: 이영빈 (yblee)
🧑🔬 연구원 리서치 노트 — 작성자: junpark (박준) (
SRAM vs DRAM 물리 구조)💡 핵심 기여 요약: 왜 온칩 SRAM은 빠르고 작으며 오프칩 DRAM(HBM)은 크고 느린지 6T SRAM 셀과 1T1C DRAM 뱅크의 물리적 회로 구조부터 명쾌하게 설명했습니다.
3주차 정리: 커널의 시간은 어디에서 소비되는가
1. 실행시간을 추정하는 모델
커널 하나의 시간은 크게 두 가지로 나눠 볼 수 있다. 계산하는 데 드는 시간과 데이터를 옮기는 데 드는 시간이다.
T_math  = (Computation FLOPs) / (Accelerator FLOPs/s)
T_comms = (Communication Bytes) / (Network or Memory Bandwidth Bytes/s)
여기서 FLOPs와 FLOPs/s는 다른 개념이다. FLOPs는 "해야 할 계산의 양"이고, FLOPs/s는 "하드웨어가 1초에 처리할 수 있는 계산의 양"이다. 그래서 FLOPs ÷ (FLOPs/s)를 하면 단위가 초(s)가 된다. 메모리 쪽도 마찬가지로 Byte ÷ (Byte/s) = s다.
통신과 연산을 완벽하게 겹칠 수 있다고 가정하면, 전체 시간은 둘 중 더 오래 걸리는 쪽이 결정한다.
예상 실행시간 ≈ max(T_math, T_comms)T_math > T_comms이면 연산 장치를 쉬지 않고 쓰고 있다는 뜻이고, 이를 연산 병목(compute-bound)이라고 한다. 반대로 T_comms > T_math이면 데이터가 도착하기를 기다리느라 연산 장치가 노는 상태이고, 이를 통신 병목(communication-bound)이라고 한다. 한 가속기 안에서 메모리 대역폭이 병목이면 특히 memory-bound라고 부른다.
이 값은 최대 성능을 그대로 대입한 이상적인 추정치이므로 "이보다 빠를 수는 없다"는 최소 실행시간의 기준으로 보면 된다.
알고리즘의 산술 집약도(Arithmetic Intensity)는 총 FLOPs를 옮겨야 하는 바이트 수로 나눈 값이다. 즉 데이터 1바이트를 가져올 때마다 계산을 얼마나 하는지를 나타낸다.
Arithmetic Intensity = (Computation FLOPs) / (Communication Bytes)2. 메모리 용량과 메모리 대역폭
"메모리가 16GB"라는 것은 한 번에 담아 둘 수 있는 데이터의 양이고, "대역폭이 1TB/s"라는 것은 1초에 옮길 수 있는 데이터의 양이다. 용량은 텐서가 메모리에 들어가는지(fit) 판단할 때 쓰고, 대역폭은 그 텐서를 옮기는 데 얼마나 걸리는지 계산할 때 쓴다. 용량이 충분하다고 해서 빨라지는 것은 아니다.
3. 메모리 계층: 왜 HBM(DRAM)과 SRAM이 함께 필요한가
GPU의 HBM은 DRAM의 한 종류로, DRAM 다이를 여러 층 쌓아 넓은 버스로 연결한 것이다. 반면 L1/Shared Memory, L2 캐시, 레지스터는 SRAM으로 만든다. 두 가지를 섞어 쓰는 이유는 셀 구조에서부터 나온다.
SRAM 6T vs DRAM 1T1C
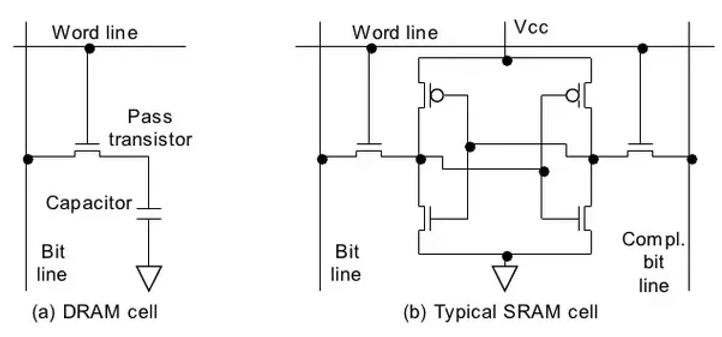
SRAM 셀의 동작
SRAM 셀의 핵심은 인버터 두 개를 서로 물려 놓은 구조(cross-coupled inverter, 트랜지스터 4개)다. 한쪽 출력 Q가 1이면 반대쪽 QB는 0이 되고, 두 인버터가 서로의 입력을 계속 밀어주기 때문에 전원이 있는 한 값이 스스로 유지된다. 나머지 트랜지스터 2개는 이 래치를 비트라인 BL, BLB에 연결하는 문(access transistor) 역할을 하며, 워드라인(WL)이 켜질 때만 열린다.
- 유지: WL이 꺼져 있으면 래치가 비트라인과 분리되어 값을 그대로 붙잡고 있다. 리프레시가 필요 없다.
- 읽기: BL과 BLB를 둘 다 VDD로 미리 충전(precharge)한 뒤 WL을 켠다. 0을 저장한 쪽 노드가 자기 비트라인의 전압을 조금 끌어내리고, 감지 증폭기가 BL과 BLB의 작은 전압 차이를 보고 값을 판별한다. 래치가 계속 값을 붙잡고 있으므로 읽어도 값이 깨지지 않는다.
- 쓰기: 쓰려는 값에 맞춰 BL과 BLB를 각각 1과 0(또는 그 반대)으로 강하게 구동한 뒤 WL을 켠다. 비트라인 드라이버가 래치보다 세게 밀어서 상태를 뒤집는다.
DRAM 셀의 동작
DRAM 셀은 커패시터 하나에 전하가 있으면 1, 없으면 0으로 저장하고, 트랜지스터 하나가 이 커패시터를 비트라인에 연결하는 스위치 역할을 한다. 값을 스스로 유지하는 회로가 없고 전하만 담아 두는 방식이라 구조가 단순하다.
- 쓰기: WL을 켜서 트랜지스터를 열고, 비트라인을 VDD 또는 0으로 구동해 커패시터를 충전하거나 방전시킨다.
- 유지: WL을 끄면 전하가 커패시터에 갇힌다. 하지만 누설 전류 때문에 전하가 조금씩 새어 나가므로, 값이 사라지기 전에 주기적으로 읽고 다시 써 주는 리프레시(refresh)가 필요하다. 일반적인 DRAM은 모든 행을 약 64 ms 안에 한 번씩 리프레시한다.
- 읽기: 비트라인을 VDD/2로 미리 맞춰 둔 뒤 WL을 켜면, 커패시터와 비트라인이 전하를 나눠 가지면서 비트라인 전압이 아주 조금 오르거나 내린다. 셀 커패시터가 비트라인보다 훨씬 작아서 변화가 미세하기 때문에 감지 증폭기로 증폭해야 하고, 이 과정에서 셀의 원래 전하가 사라지므로 읽은 값을 다시 써 넣어야 한다. 자세한 과정은 아래 "DRAM은 어떻게 읽는가"에서 뱅크 단위로 다룬다.
정리하면 SRAM은 회로가 값을 능동적으로 붙잡고 있어서 빠르고 읽어도 값이 유지되지만 셀이 크다. DRAM은 전하를 수동적으로 담아 둘 뿐이라 셀이 작지만, 읽을 때 증폭과 복구가 필요하고 주기적인 리프레시까지 해야 해서 느리다.
트랜지스터 개수만 보면 면적이 3배쯤 차이 날 것 같지만, 실제로는 훨씬 크다. 공정 최소 선폭을 F라고 할 때 DRAM 셀은 약 6F², SRAM 셀은 약 120~150F²로 20~30배 정도 차이가 난다. 이유는 세 가지다.
첫째, DRAM의 커패시터는 평면 면적을 거의 차지하지 않는다. 커패시터를 트랜지스터 위로 높게 쌓거나(stacked) 기판 아래로 파서(trench) 만들기 때문에, 셀 면적은 사실상 트랜지스터 하나와 콘택으로 결정된다. "1T1C"라고 해도 평면상으로는 "1T"에 가깝다.
둘째, SRAM은 트랜지스터 외의 부대 비용이 크다. 6T 안에 PMOS와 NMOS가 섞여 있어 N-well/P-well을 분리할 간격이 필요하고, 셀 하나에 비트라인 2개(BL, BLB), 워드라인, VDD, GND가 모두 연결되어야 해서 콘택과 배선이 많다. 결국 배선과 콘택의 피치가 면적을 좌우한다.
셋째, DRAM은 메모리 전용 공정으로 극단적으로 최적화되어 있다. 매립형 워드라인(buried wordline), 인접한 두 셀이 비트라인 콘택을 공유하는 구조, 규칙적인 배열에 맞춘 패터닝 등을 쓴다. 반면 SRAM은 로직과 같은 공정에서 만들어야 하므로 로직용 디자인 룰의 제약을 그대로 받는다.
정리하면 DRAM은 싸고 용량이 크지만 느리고, SRAM은 빠르지만 비싸고 용량이 작다. 그래서 큰 데이터는 HBM에 두고, 지금 계산에 쓸 데이터만 SRAM으로 가져와 쓰는 계층 구조가 된다.
DRAM은 어떻게 읽는가
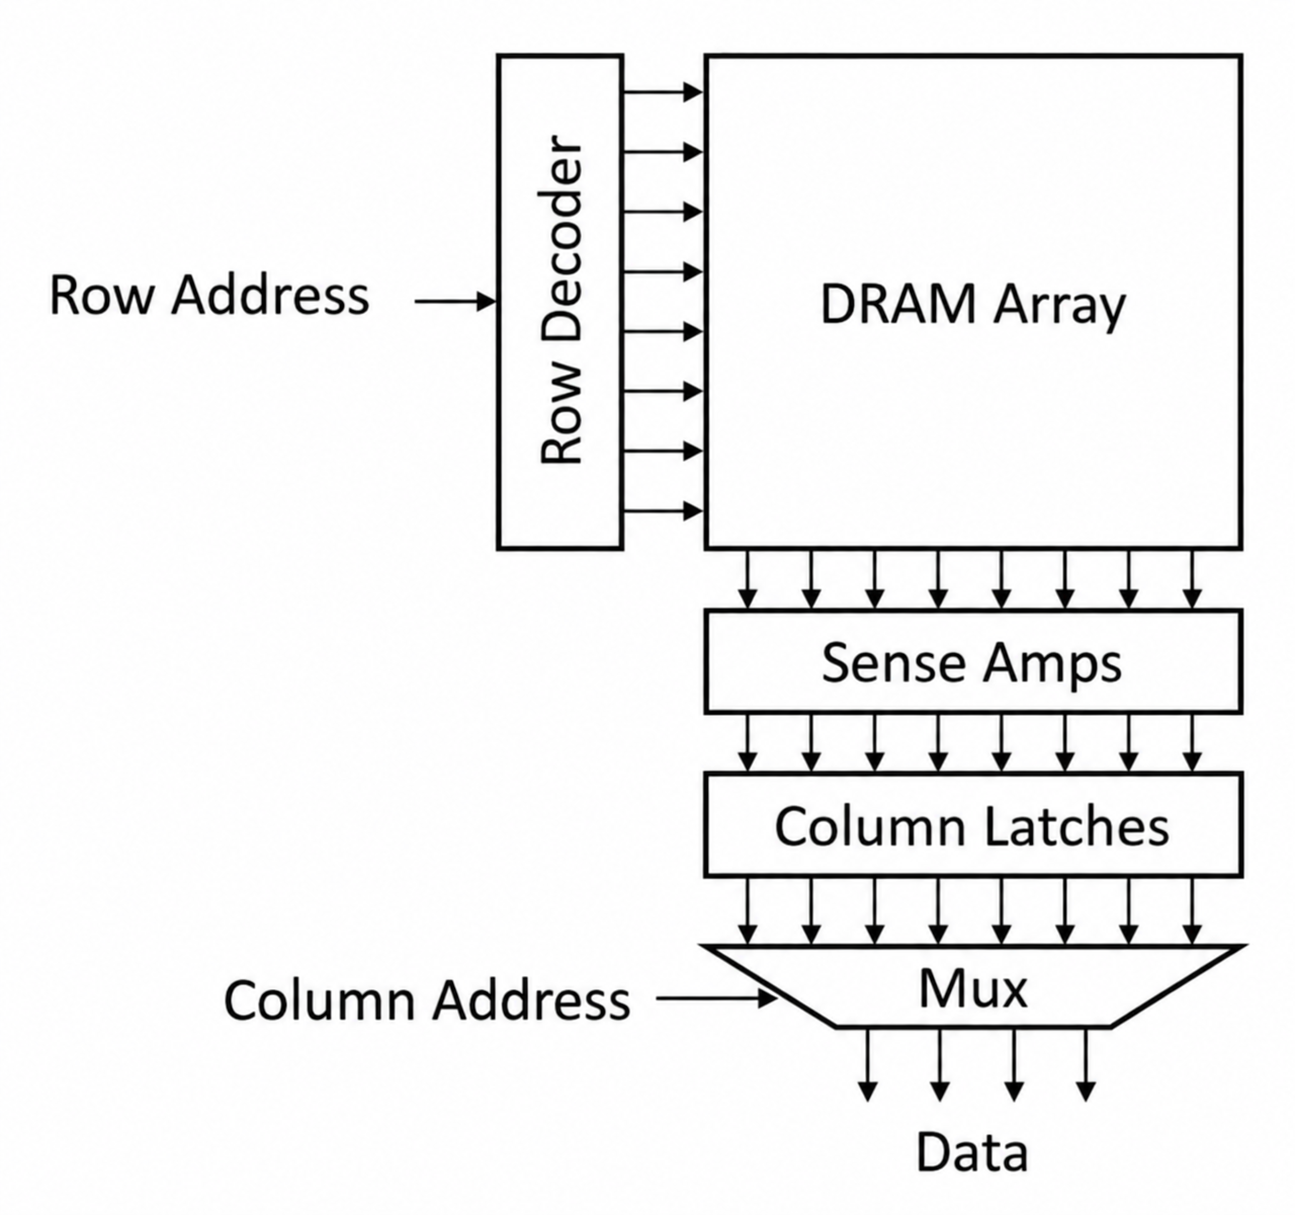
- Row Decoder에 행 주소(Row Address)를 준다. 디코더는 원하는 행 하나의 워드라인만 1로, 나머지는 0으로 만든다.
- 워드라인이 켜지면 그 행에 있는 모든 셀의 커패시터가 비트라인과 연결되어 전하를 나눈다(charge sharing). 비트라인 전압이 아주 조금 올라가거나 내려간다.
- 감지 증폭기(Sense Amplifier)가 이 미세한 전압 변화를 감지해 0인지 1인지 판별하고, 값을 완전한 0/1 전압으로 증폭한다.
- 증폭된 값은 Column Latch(Row Buffer)에 보관된다.
커패시터의 전하는 비트라인과 나눠 가지면서 원래 값을 잃기 때문에, DRAM 읽기는 값을 파괴하는 읽기(destructive read)다. 그래서 감지 증폭기가 증폭한 값을 다시 셀에 써 넣어(restore) 원래 값을 복구한다. Row Buffer에 올라온 값은 그대로 유지되므로, 같은 행의 다른 데이터를 또 읽을 때는 셀까지 가지 않고 바로 꺼내 쓸 수 있다.
행 하나는 보통 한 번의 요청 크기보다 훨씬 크다. 그래서 주소의 열 주소(Column Address) 부분이 멀티플렉서로 전달되어, Row Buffer에서 필요한 부분만 골라낸다. 이렇게 한 번의 열 접근으로 버스를 통해 연속해서 내보내는 데이터 묶음을 DRAM Burst라고 한다(행 전체가 아니라 그중 일부다).
가장 느린 부분은 DRAM Array, 감지 증폭기, Column Latch 쪽이다. 행을 열고(activate) 감지·증폭하고 다시 닫는(precharge) 과정이 오래 걸린다. 반면 이미 열린 행에서 멀티플렉서로 열을 고르는 것은 비교적 빠르다. 그래서 같은 행 안의 데이터를 연속으로 읽는 순차 접근이 훨씬 유리하다.
GPU에서의 접근 단위
- SMEM(Shared Memory): SM 하나당 4바이트 폭의 뱅크 32개로 나뉘어 있다.
- L1 ↔ L2 ↔ DRAM: 128바이트 캐시 라인 단위로 관리하며, 실제 전송은 32바이트 섹터 단위로 일어난다.
메모리 coalescing (Global Memory): 스레드가 4B만 원해도 그 값이 들어 있는 32B 섹터 전체가 옮겨진다. 그래서 워프의 스레드들이 연속된 주소를 함께 읽으면 적은 섹터로 요청을 채울 수 있지만, 주소가 흩어지면 건드리는 섹터 수가 늘어 쓰지도 않을 바이트까지 옮기게 된다. 최악의 경우 float 하나씩 읽는 워프가 128B를 쓰려고 1024B를 옮긴다. 메모리 시간 공식에 들어가는 Byte는 "사용한 바이트"가 아니라 "실제로 전송된 바이트"라는 점에서 손계산과 직결된다.
뱅크 충돌 (Shared Memory): 4B 워드는 (바이트 주소 / 4) % 32번 뱅크에 놓이고, 각 뱅크는 한 번에 4B 워드 하나만 처리한다. 워프의 여러 스레드가 같은 뱅크의 서로 다른 주소를 요청하면 요청을 여러 번에 나눠 처리해야 하는데, 이를 뱅크 충돌이라고 한다. 가장 많이 몰린 뱅크에 서로 다른 주소가 n개 있으면 n-way 충돌이고 n번에 나눠 처리된다. 같은 주소를 여러 스레드가 읽는 것은 한 번 읽어 나눠 주는 broadcast라 충돌이 아니다.
예를 들어 float tile[32][32]에서 스레드 i가 tile[i][c]를 읽으면(한 열을 나눠 읽는 경우) 인덱스가 i * 32 + c라서 32개 스레드가 모두 c번 뱅크에 몰려 32-way 충돌이 난다. 배열을 [32][33]으로 한 칸 늘리면(padding) 인덱스가 i * 33 + c, 뱅크가 (i + c) % 32가 되어 스레드마다 뱅크가 달라지고 충돌이 사라진다. 쓰기도 같은 규칙을 따른다.
두 개념은 비슷해 보이지만 보는 기준이 다르다. coalescing은 주소들이 얼마나 모여 있는가(몇 개 섹터에 걸치는가)를 보고, 손해는 불필요한 바이트 전송이다. 뱅크 충돌은 주소들이 32개 뱅크에 얼마나 골고루 퍼져 있는가를 보고, 손해는 요청이 여러 번에 나눠 처리되는 직렬화다.
4. Vector Add 손계산
길이 N = 10⁸인 FP32 벡터 A, B를 더해 C에 저장한다. 원소 하나는 4B이고, 가상 하드웨어의 연산 성능은 20 × 10¹² FLOPs/s, HBM 대역폭은 1 × 10¹² B/s다. 입력은 한 번씩 읽고 결과는 한 번 쓰며, 캐시 재사용은 없다고 가정한다.
| 항목 | 계산 | 값 |
|---|---|---|
| A, B 읽기 | 2 × 10⁸ × 4B | 8 × 10⁸ B |
| C 쓰기 | 10⁸ × 4B | 4 × 10⁸ B |
| 총 이동량 | 읽기 + 쓰기 | 1.2 × 10⁹ B |
| 총 FLOPs | 원소당 덧셈 1번 | 10⁸ FLOPs |
| 연산 시간 | 10⁸ / (20 × 10¹²) | 5 × 10⁻⁶ s (5 µs) |
| 메모리 시간 | 1.2 × 10⁹ / 10¹² | 1.2 × 10⁻³ s (1.2 ms) |
메모리 시간(1.2 ms)이 연산 시간(5 µs)보다 약 240배 크므로, 예상 실행시간은 약 1.2 ms이고 이 커널은 memory-bound다. 연산 장치는 전체 시간의 0.4% 정도만 일하고 나머지는 데이터를 기다린다. 결과를 쓰는 시간도 빼먹으면 안 된다. 쓰기를 빼면 0.8 ms로 계산되어 실제보다 1/3가량 과소평가하게 된다.
산술 집약도로 봐도 같은 결론이 나온다.
- Vector Add의 산술 집약도: 10⁸ FLOPs / 1.2 × 10⁹ B = 1/12 FLOPs/B
- 하드웨어의 ridge point: (20 × 10¹² FLOPs/s) / (10¹² B/s) = 20 FLOPs/B
커널은 바이트당 1/12번 계산하는데, 하드웨어는 바이트당 20번 계산할 여력이 있다. 1/12 < 20이므로 memory-bound이고, 그 비율(20 ÷ 1/12 = 240)이 위에서 구한 시간 비율과 정확히 같다.
무엇을 늘려야 빨라지는가
- 연산 성능을 2배로: 연산 시간만 5 µs → 2.5 µs로 줄고, 전체 시간은 여전히 1.2 ms다. 거의 변화 없음.
- 메모리 대역폭을 2배로: 메모리 시간이 0.6 ms로 줄어 전체 시간도 거의 절반이 된다.
- 메모리 용량을 늘림: 필요한 데이터는 1.2 GB라 16 GB에 이미 들어가므로 속도에는 영향이 없다.
결국 이 커널을 빠르게 하는 것은 대역폭이다.
5. Triton 코드와 손계산 연결
@triton.jit
def vecAdd(a_ptr, b_ptr, c_ptr, N, BLOCK_SIZE: tl.constexpr):
    pid = tl.program_id(0)
    offsets = pid * BLOCK_SIZE + tl.arange(0, BLOCK_SIZE)
    mask = offsets < N
    a = tl.load(a_ptr + offsets, mask=mask)   # 원소당 4B 읽기
    b = tl.load(b_ptr + offsets, mask=mask)   # 원소당 4B 읽기
    tl.store(c_ptr + offsets, a + b, mask=mask)  # 덧셈 1 FLOP, 4B 쓰기

grid = (triton.cdiv(N, BLOCK_SIZE),)
vecAdd[grid](a, b, c, N, BLOCK_SIZE=512)
각 프로그램 인스턴스는 512(BLOCK_SIZE)개 원소를 맡는다. 원소 하나당 tl.load 두 번으로 8B를 읽고, a + b로 1 FLOP을 계산하고, tl.store로 4B를 쓴다. 원소당 12B를 옮기고 1 FLOP을 하니 산술 집약도 1/12가 코드에서 그대로 보인다.
grid의 triton.cdiv(N, BLOCK_SIZE)는 올림 나눗셈이다. CUDA에서는 같은 계산을 정수 나눗셈으로 (N + BLOCK_SIZE - 1) / BLOCK_SIZE처럼 쓰는 경우가 많다. N = 10⁸을 512로 나누면 195,312.5이므로 grid는 올림해서 195,313개가 되고, 마지막 블록에서 N을 넘는 부분은 mask로 걸러낸다.
스레드는 몇 개의 원소를 맡는가
프로그램 인스턴스 하나가 512개 원소를 맡는다고 해서 스레드 하나가 512개를 읽는 것은 아니다. 그렇다고 CUDA의 기본 예제처럼 스레드 하나가 float 하나를 읽는 것도 아니다. num_warps를 따로 주지 않으면 기본값 4가 적용되어, 프로그램 인스턴스 하나에 4워프 × 32 = 128개 스레드가 붙는다. 따라서 512 / 128 = 4, 즉 스레드 하나가 연속된 float 4개를 맡는다.
float4와의 연결
float 4개는 4B × 4 = 16B = 128비트다. 주소가 16B 단위로 정렬되어 있고 연속이라는 것을 컴파일러가 알 수 있으면, Triton은 이 4개를 128비트 벡터 load 명령 하나로 읽는다(PTX에서 ld.global.v4 계열로 보인다). CUDA에서 float4 타입으로 직접 읽는 것과 같은 효과다.
__global__ void vecAdd4(const float4* a, const float4* b, float4* c, int N4) {
    int i = blockIdx.x * blockDim.x + threadIdx.x;   // N4 = N / 4
    if (i < N4) {
        float4 x = a[i], y = b[i];
        c[i] = make_float4(x.x + y.x, x.y + y.y, x.z + y.z, x.w + y.w);
    }
}
CUDA에서는 N이 4로 나누어떨어지고 포인터가 16B로 정렬되어 있다는 것을 프로그래머가 보장해야 하고, 그렇지 않으면 남는 원소를 따로 처리해야 한다. Triton은 포인터와 N이 16의 배수인지 보고 이 판단을 자동으로 한다. 여기서는 N = 10⁸이 16의 배수라 조건을 만족한다.
메모리 접근 단위로 보면 워프 하나의 32개 스레드가 각각 16B씩 연속으로 읽으므로 한 번에 512B, 즉 128B 캐시 라인 4개(32B 섹터 16개)를 낭비 없이 채운다. 이렇게 연속된 주소를 워프 단위로 묶어 읽는 것이 coalesced access다.
벡터화는 옮기는 바이트 수를 줄이지 않는다. 원소당 12B, 총 1.2 × 10⁹ B는 그대로이므로 이상적 실행시간 1.2 ms도 같다. 대신 load/store 명령 수가 1/4로 줄어서 적은 명령으로 메모리 요청을 충분히 띄울 수 있고, 실제 실행시간이 대역폭 한계에 더 가까워진다.
| 입력 조건 | 생성된 load |
|---|---|
| N=1,048,576, 포인터 16B 정렬 | ld.global.v4.b32 |
| N=1,048,577, 포인터 16B 정렬 | ld.global.b32 |
| N=1,048,576, 포인터를 원소 하나만큼 이동 | ld.global.b32 |