✍️ 메인 교안 집필: 이영빈 (yblee)
🧑🔬 연구원 리서치 노트 — 작성자: junpark (박준) (
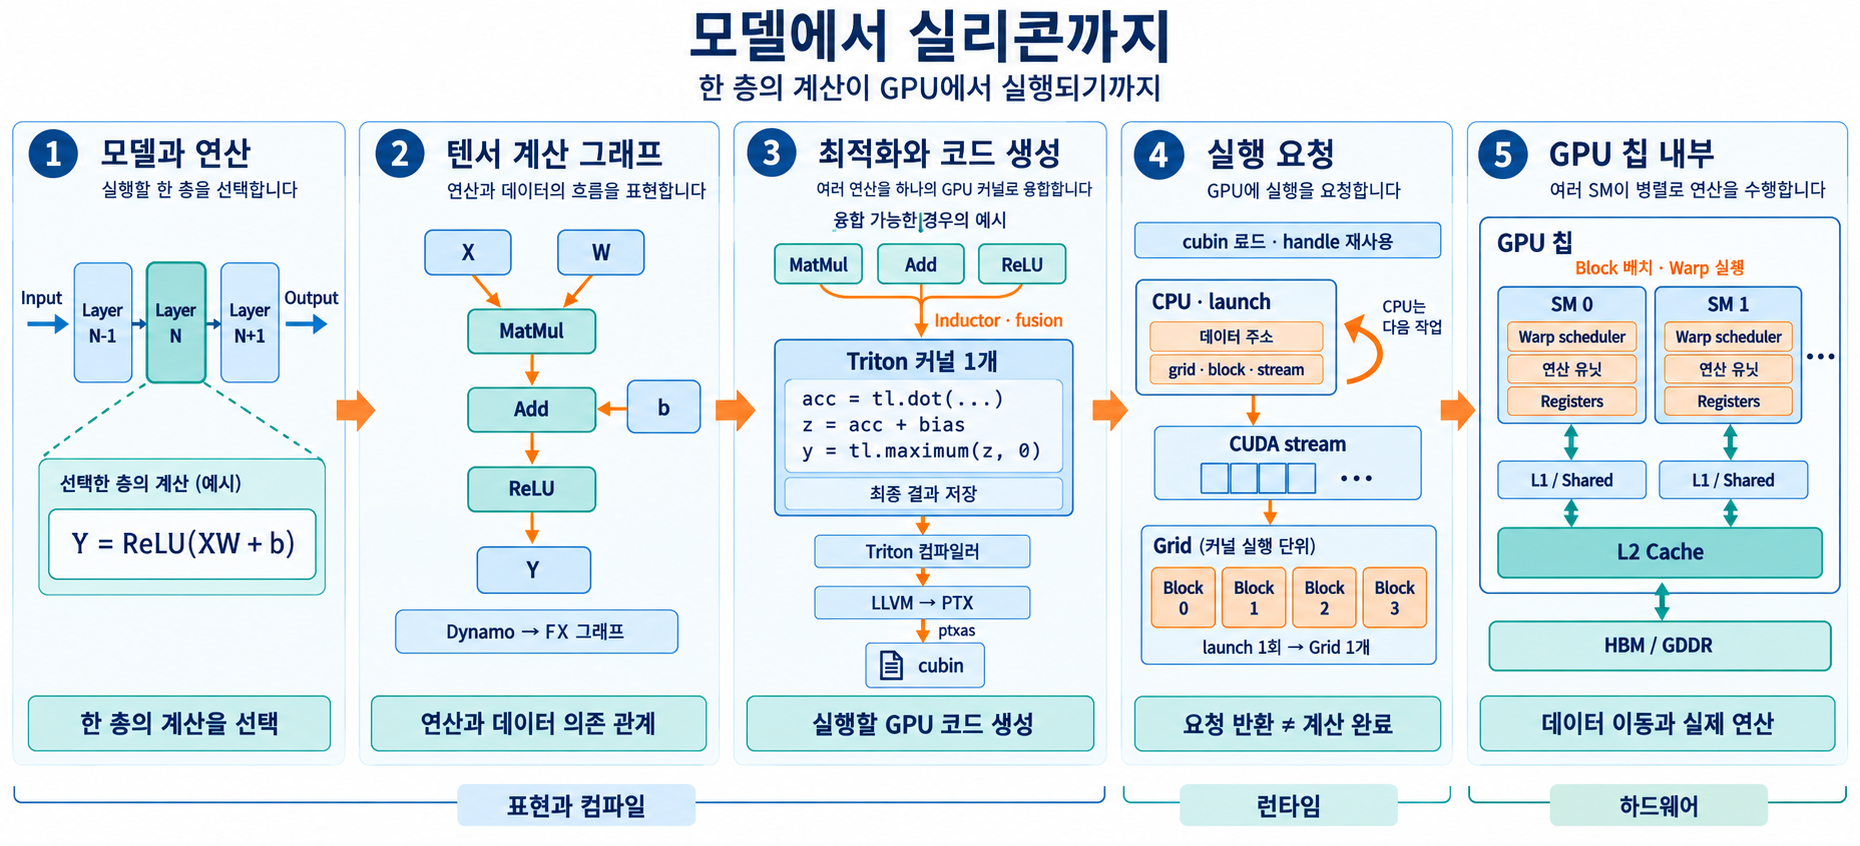
실행 스택 핵심 요약)💡 핵심 기여 요약: Python 바이트코드 변환(TorchDynamo)과 GPU 하드웨어 계층 구조의 연결 고리를 핵심 도식 중심으로 압축 정리했습니다.
1. 모델 -> 연산
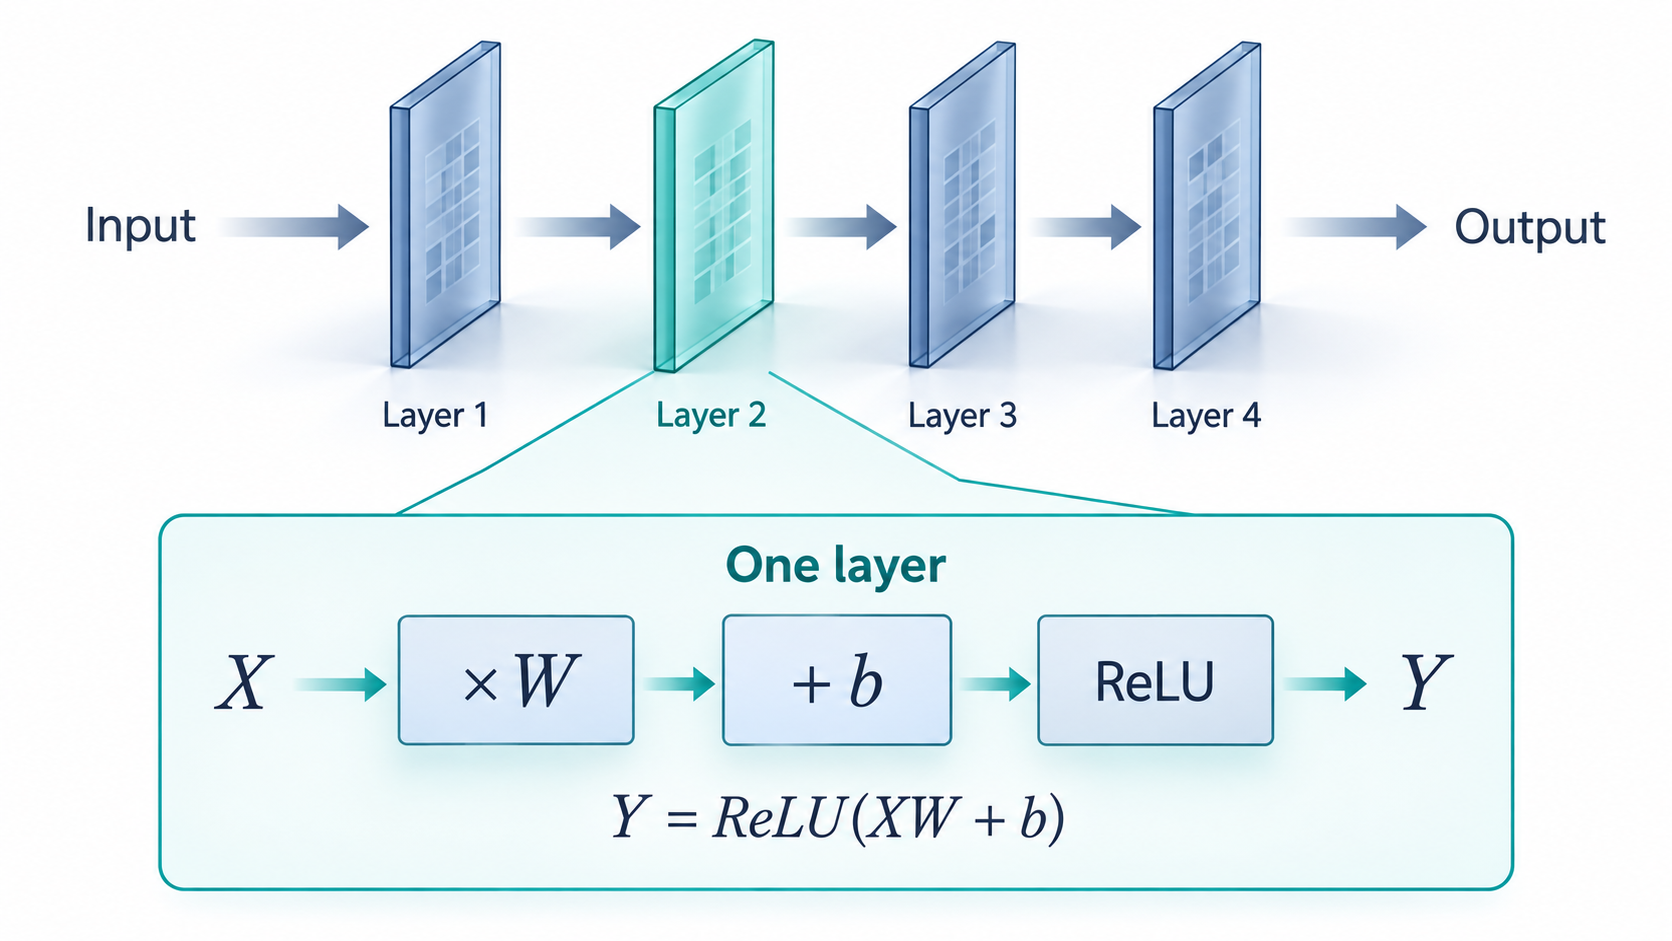
기초적인 딥러닝 모델은 입력과 wegiht를 곱하고 bias를 더한뒤 ReLU를 통과시키는 층을 여러개 쌓은 형태이다. 한층을 분리해 Y = ReLU(XW + b).
2. 연산 -> 텐서 계산 그래프
jax.jit나 torch.compile을 적용하지 않으면, 기본적으로 Python 실행을 따라 만나는 연산을 차례로 호출한다. PyTorch의 경우 기존에 준비된 연산 구현, 라이브러리 커널을 호출하지만, JAX eager의 경우 개별 연산에도 XLA 컴파일이 적용된다고 한다. Pytorch의 경우, TorchDynamo가 이부분을 담당하며 eager 모드와 다음과 같은 차이가 있다.
일반적인 Python에서 foo(...)를 호출하면 인자·지역 변수·실행 위치 등 이번 호출의 상태를 담는 PyFrameObject가 준비되고, 이 PyFrameObject는 foo의 코드가 담긴 PyCodeObject를 참조한다. 이후 _PyEval_EvalFrameDefault()가 해당 코드의 bytecode를 따라 Frame의 값을 읽고 갱신하며 함수를 실행하고, 결과를 반환한다.
TorchDynamo는 Frame 실행에 개입해 먼저 guard로 캐시된 변환 코드를 재사용할 수 있는지 확인한다. 사용할 코드가 없으면 bytecode를 분석해 tensor 연산을 FX 그래프로 추출하고 backend(default: TorchInductor)에 컴파일을 맡긴 뒤, 컴파일된 함수를 호출하도록 python 코드를 변환한다. 이후 변환된 코드를 수행하면서 남은 Python 동작과 컴파일된 함수 호출을 이어간다. 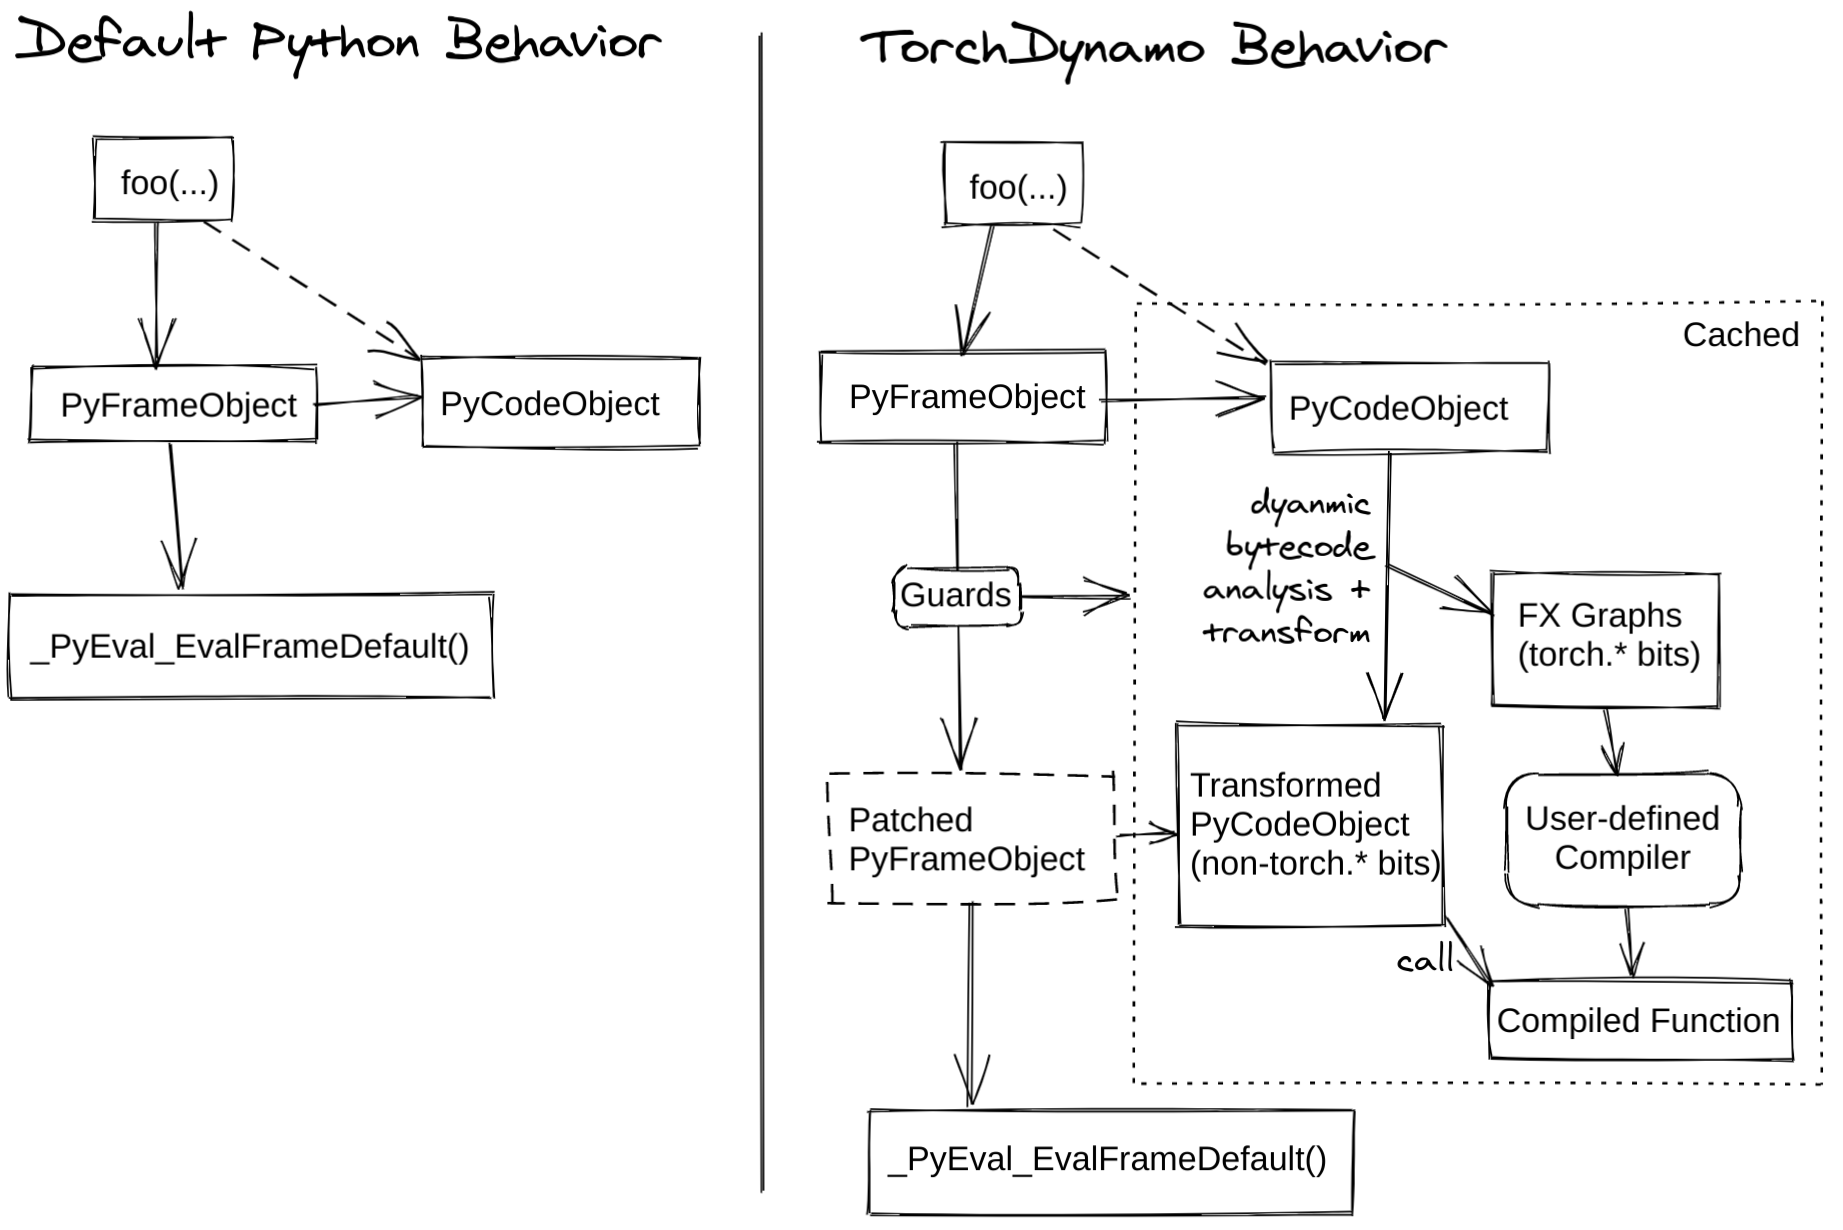
FX 그래프는 연산과 데이터 의존 관계를 나타낸 그래프 자료 구조이다. Transformer의 여러 층은 코드에서 반복문으로 표현할 수 있지만, 이를 펼친 순전파 연산 그래프에서는 각 층의 계산이 앞선 결과를 받아 다음 결과를 만드는 방향으로 연결된다. 따라서 반복되는 계산 패턴이 있어도, 데이터 의존 관계는 순환 없는 방향 그래프(DAG)로 나타낼 수 있다.
TorchDynamo는 그래프 캡처 과정에서 정적인 Python 계산을 미리 평가하고, 알려진 조건에 따라 실행 경로를 특수화하며, 함수 호출과 고정된 반복 구조를 펼쳐 tensor 연산을 포착한다. 이러한 가정은 guard로 관리하고, fusion이나 메모리 배치 같은 하드웨어 실행 최적화는 주로 이후 backend가 수행한다.
추가적으로 Dynamo가 만든 FX 그래프를 받아서 AOTAutograd가 functionalization, decomposition을 작업하여 ATen 연산 중심의 FX 그래프를 결과물로 만들어 준다. 또 학습시 미분 계산 및 forward, backward 그래프를 분할 하는일도 한다. 이후단계인 TorchInductor는 AOTAutograd를 반드시 사용하지만 다른 backend의 경우 사용하지 않는 경우도 있다.
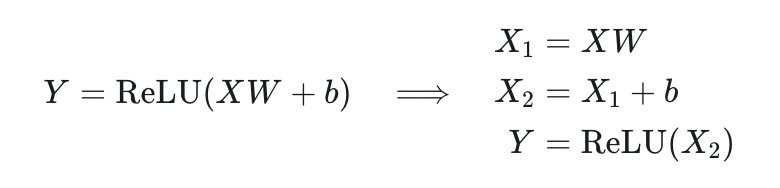
- TorchDynamo 개요
- torch.compile 해부 1편: TorchDynamo, AOTAutograd, TorchInductor
- Architectural Deep Dive: torch.dynamo and PyTorch 2.0 Performance
3. 텐서 계산 그래프 -> 실행코드
XLA의 HLO 최적화 — fusion, layout 등 결정 ↓ LLO — TPU 내부의 데이터 이동과 연산을 구체적으로 표현
대상 하드웨어 코드 생성 XLA architecture가 제시하는 목적은 실행 시간 감소, 메모리 사용 개선, 수작업 custom op 의존 감소, 새로운 하드웨어로의 이식성이다. 이를 위해 target-independent 변환과 target-specific 변환을 나누고, backend가 하드웨어에 맞는 코드 생성과 라이브러리 선택을 수행한다.
LLO -> VLIW bundle(기계어)
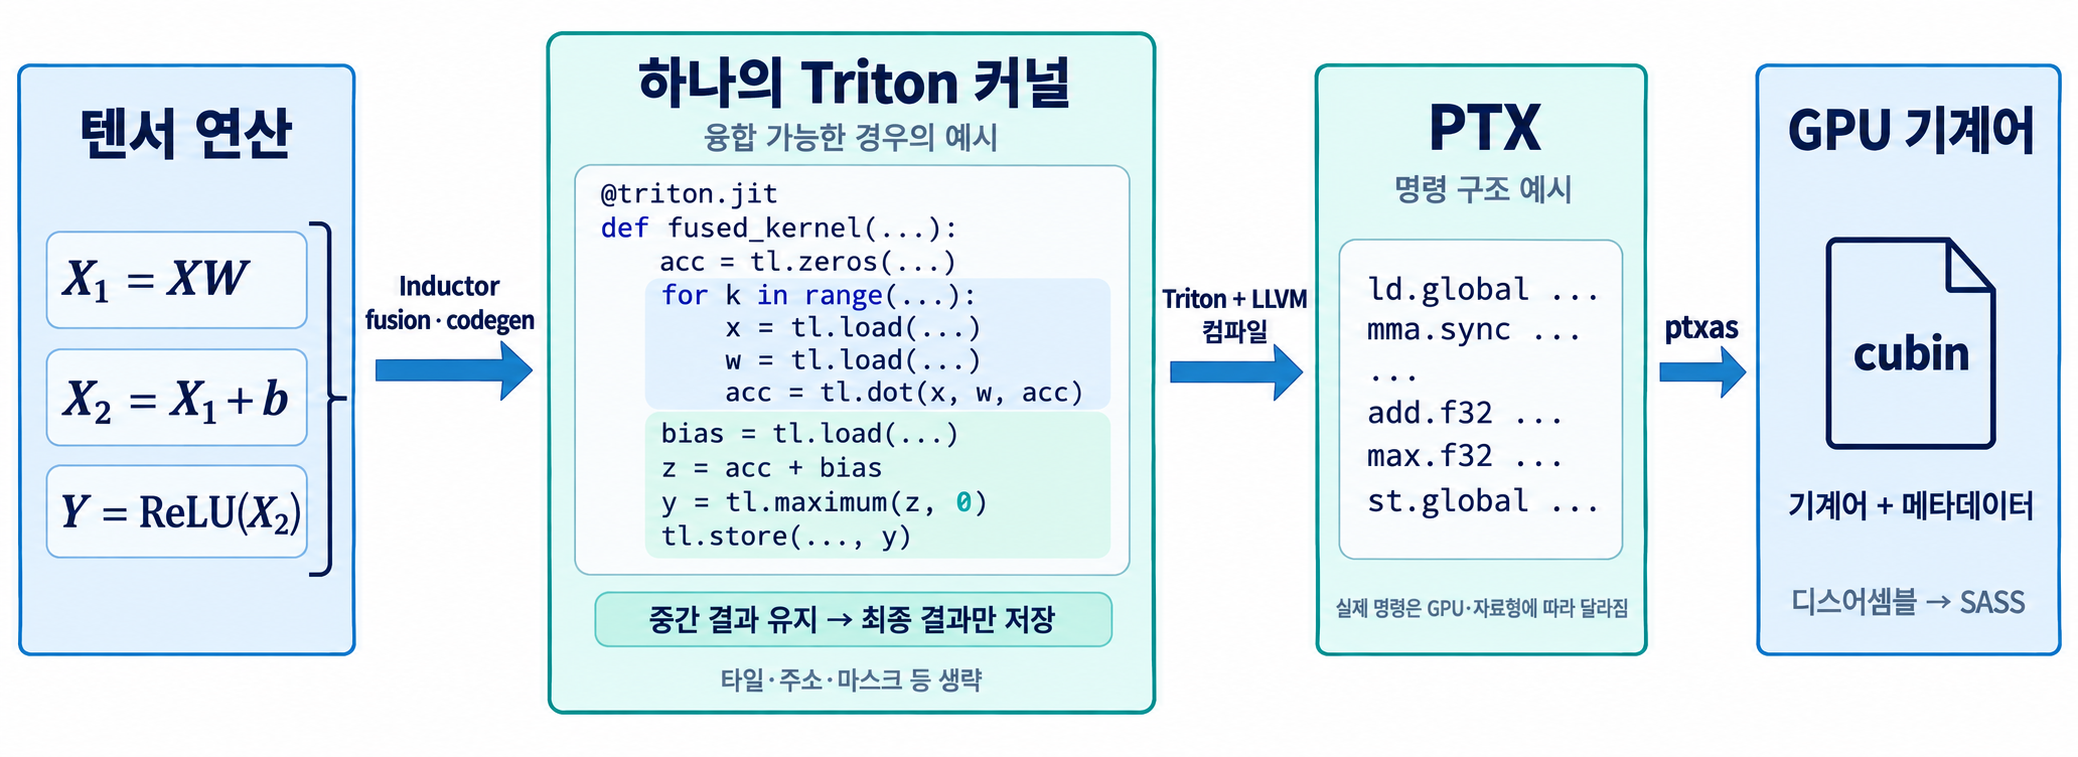
Inductor가 Triton을 통해 NVIDIA GPU용 코드를 생성하는 대표적인 경로를 다뤄보고자 한다. 연산에 따라서는 커널 소스를 직접 생성하는 대신 기존 라이브러리나 외부 커널을 호출하기도 한다. Inductor는 연산을 보다 낮은 수준의 계산과 메모리 접근으로 바꾸고, fusion과 스케줄 등을 결정해 실제 커널 소스 코드를 만든다.
그동안의 그래프는 tensor 연산을 표현하고 있었다. 다음 단계에서 Inductor가 lowering을 통해 tensor 연산을 반복 범위와 각 인덱스에서 수행할 계산, 메모리 접근으로 표현해 loop-level IR 결과물을 내놓는다. 이어서 Inductor의 스케줄링 단계에서는 어떤 연산들을 하나의 커널로 fusion할지, 커널들을 어떤 순서로 실행할지 결정하고, 버퍼를 제거하거나 재사용하기 위한 메모리 계획을 수행한다. 다음으로 codegen 단계에 들어서는데 기본적으로 GPU에서는 Triton, CPU에서는 OpenMP를 사용한 C++로 하게 된다. Inductor의 Triton codegen을 기준으로 program별 작업 범위,index 계산, reduction 구조, 설정 후보 등을 코드로 작성하게 된다.
이제는 Triton 컴파일러의 영역으로 들어오게 되는데, Triton은 먼저 코드를 파싱하고 타입, 상수 등을 처리하여 TTIR이라는 형태의 논리적인 타일 연산 구조의 IR로 표현된다. 그 다음 각 GPU에 맞추어 타일 원소의 thread 및 warp 분배, GPU layout, 행렬 연산 경로 등 구체화를 통해 TTGIR 형태로 변환된다. 마지막으로 Triton compiler는 TTGIR에 표현된 GPU layout과 연산을 바탕으로 더 낮은 수준의 LLVM IR로 lowering한다.이 과정에서는 타일 단위 연산을 각 thread가 수행할 연산, 주소 계산, GPU intrinsic 또는 inline assembly 등으로 구체화한다. 필요한 추가 메모리 배치와 동기화 처리도 관련 lowering pass에서 수행된다.
LLVM IR로 표현되어 있는 현상태에서 이제 LLVM의 NVPTX backend를 통해 NVIDIA의 가상 명령 집합인 PTX 코드로 생성된다. 마지막으로 ptx는 ptxas를 통해 대상 GPU의 기계어로 컴파일한다. 이 단계에서는 물리 register 할당, 명령 스케줄링 등의 작업이 수행되며, 결과는 cubin이라는 GPU 바이너리 형태로 만들어진다. cubin은 대상 GPU의 기계어와 커널 실행에 필요한 메타데이터를 담은 ELF 기반 바이너리이다. 그 안의 기계어를 disassemble하면 SASS 형태로 확인할 수 있다.
HyperAccel은 LPU용 Legato backend를 torch.compile에 연결해 사용한다고 설명한다. 지금 설명했던 과정들을 LPU에 맞게 유사한 역할을 수행할 것으로 생각된다.
- TorchInductor post on PyTorch dev-discuss
- Learn by doing: TorchInductor Pattern Matcher
- TorchInductor Deep Dive: Why “Define‑by‑Run” Loop‑Level IR Powers PyTorch 2.0
- Understanding PyTorch Autograd vs AOTAutograd
- PyTorch 2: Faster Machine Learning Through Dynamic Python Bytecode Transformation and Graph Compilation
- Triton Kernel Compilation Stages
- Legato: HyperAccel LPU를 위한 프로그래밍 언어
4. 실행 요청 -> 커널 실행
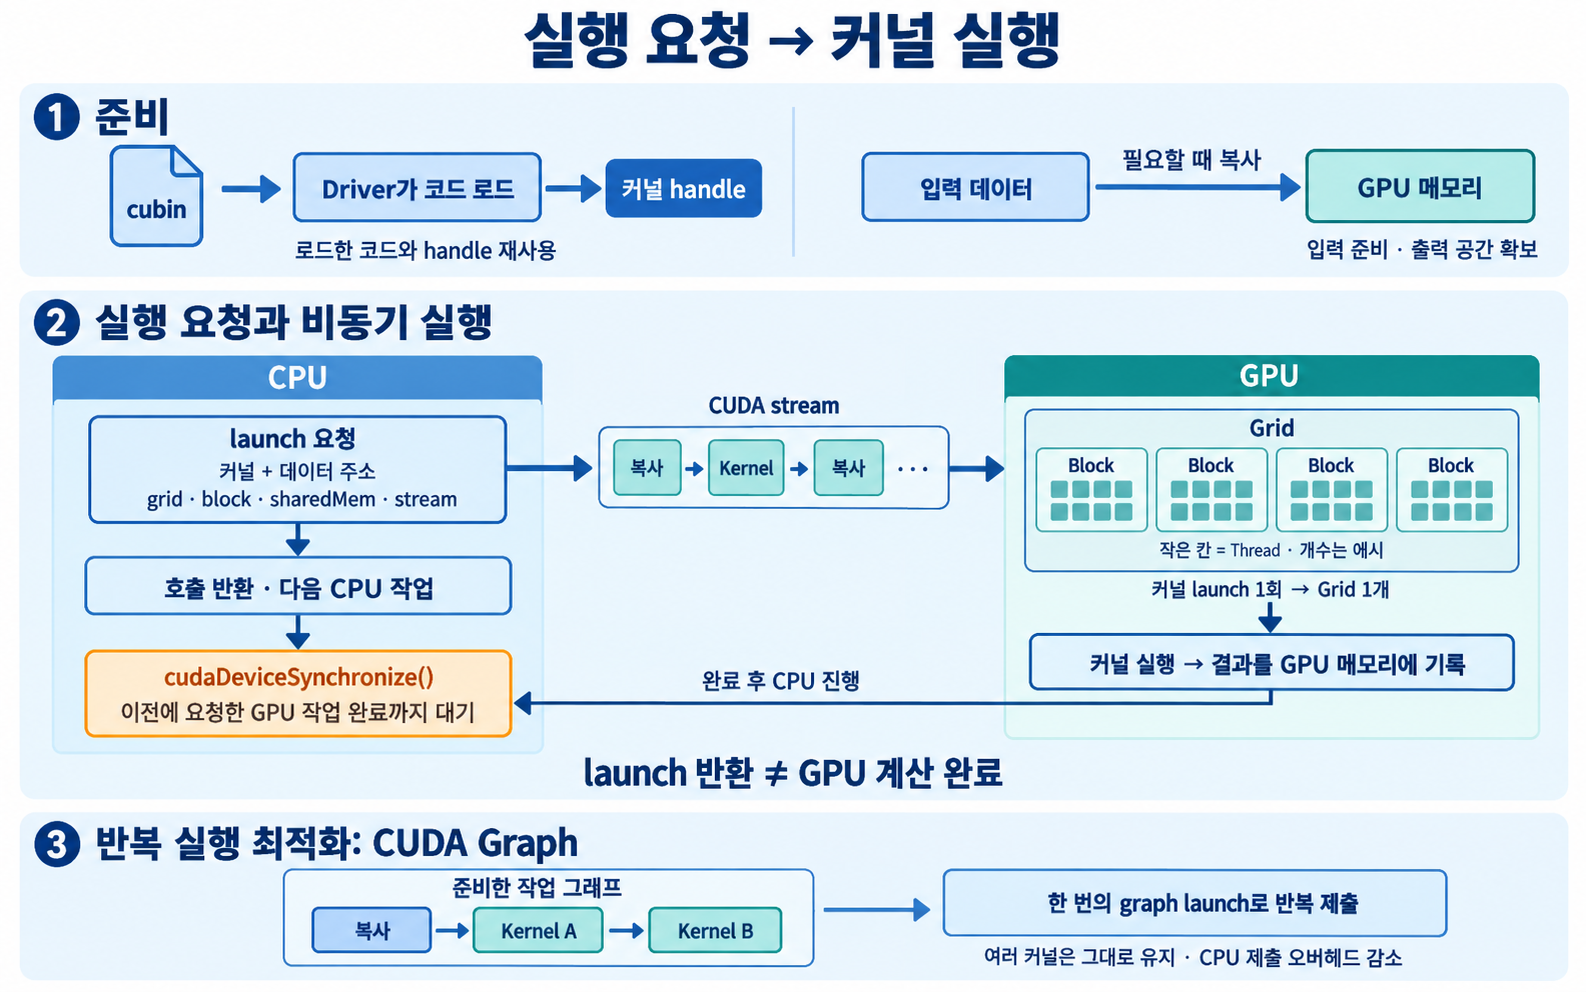
컴파일한 cubin을 driver가 로드하고, 실행할 커널을 가르키는 handle을 얻는다. 보통 로드한 코드는 이후 호출에서는 재사용한다. 입출력 데이터를 GPU에 로드해야 한다. 커널의 입력 tensor가 이미 GPU 메모리에 있을 수 있다.
쓰레드, 블록, 그리드 :커널을 한 번 launch하면 하나의 grid가 실행 됨
MatAdd<<<grid, block, sharedMemBytes, stream>>>(A, B, C);cudaDeviceSynchronize
CUDA Graph가 여러 커널 실행, 메모리 복사와 그 의존 관계를 미리 준비해두고, 이후에는 묶어서 반복 실행하는식으로 최적화가 된다.
5. 커널 -> 칩 내부
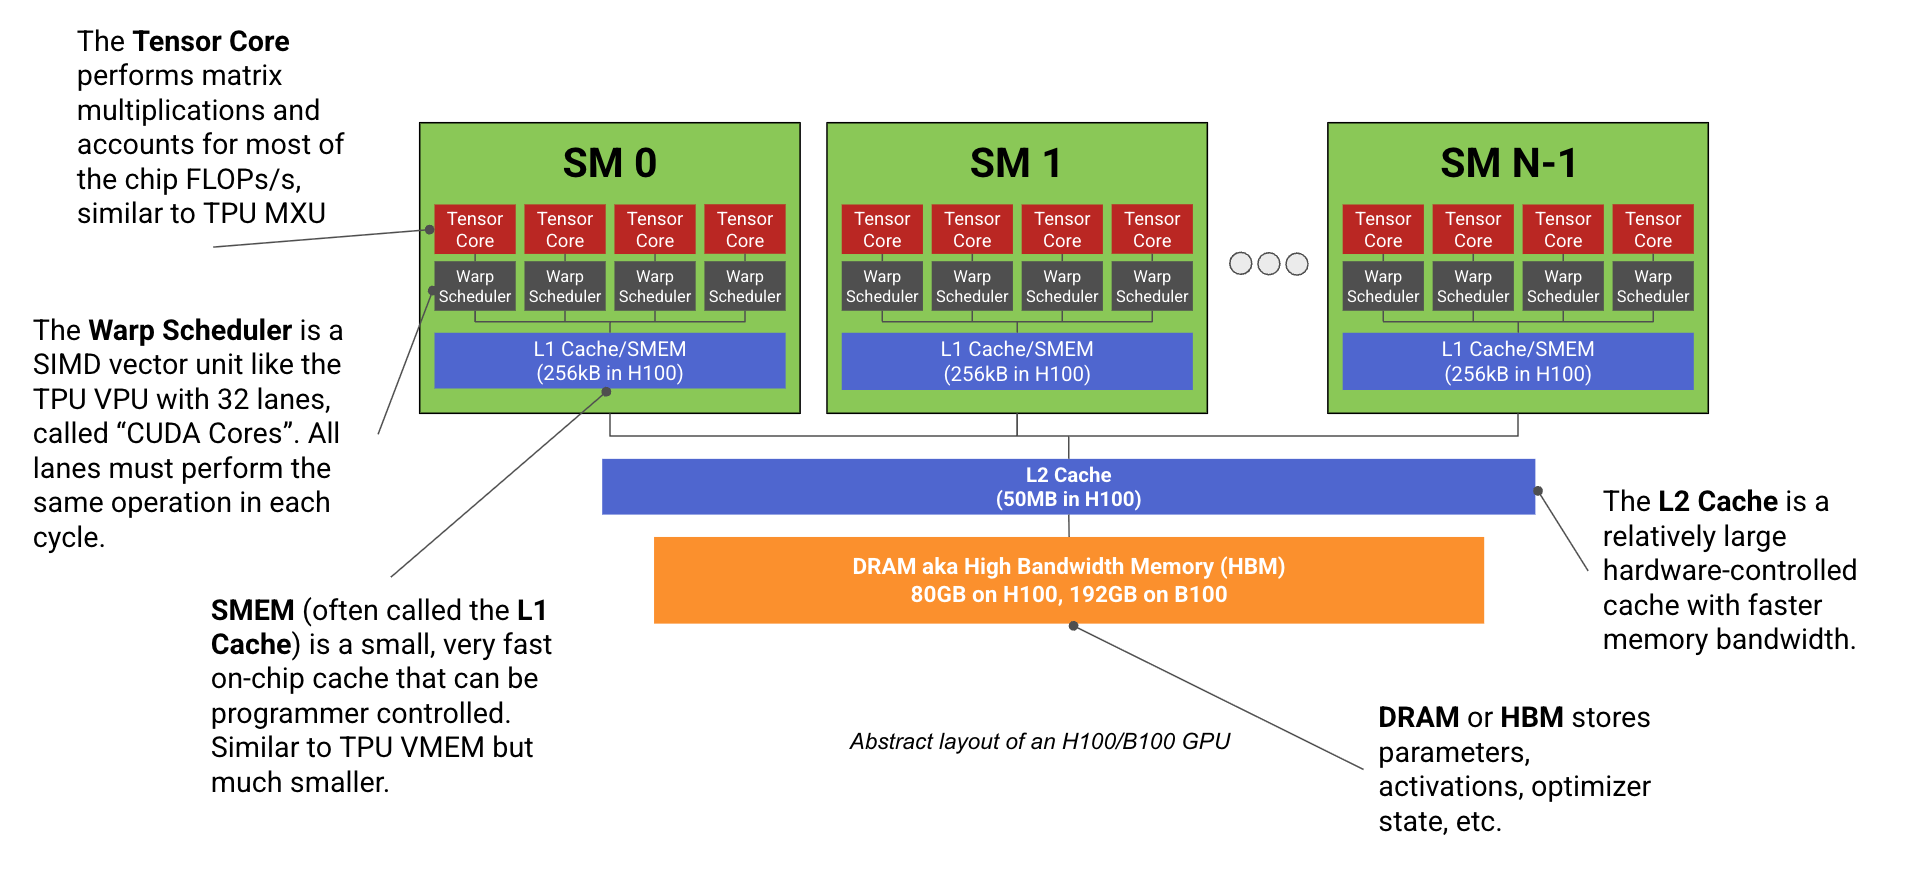
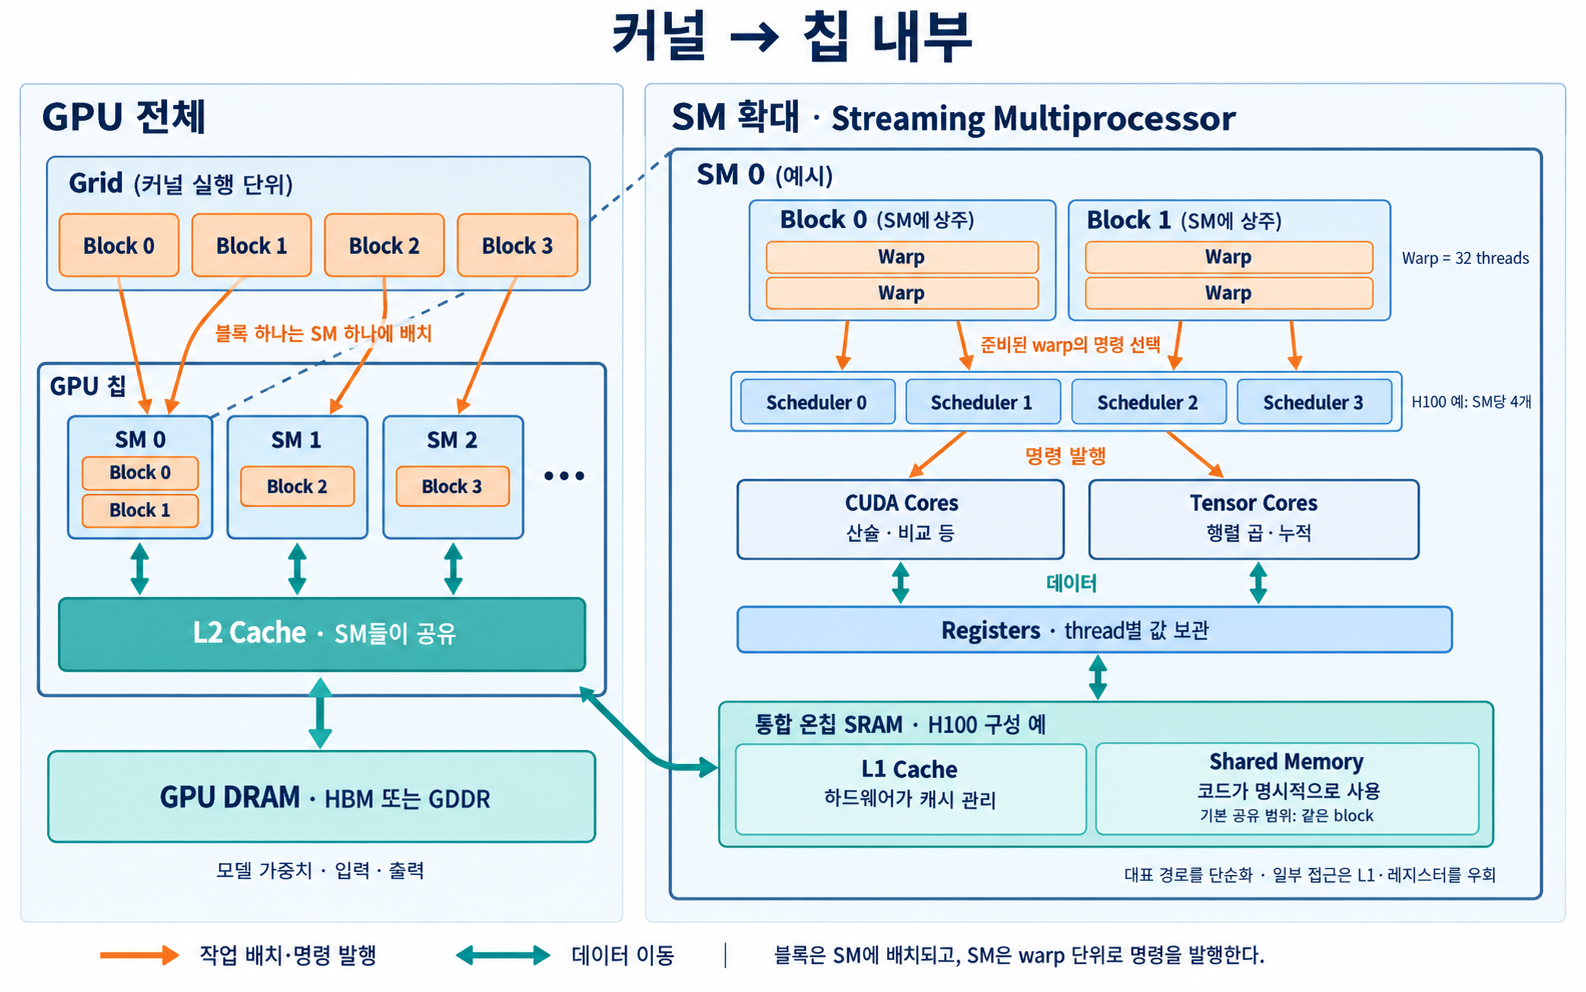
streaming multiprocessor => 명령을 스케줄하고 발행하는 기본단위 warp(32개 thread) SM 하나당 4개의 warp scheduler가 달려 있음. thread block은 하나의 SM에 배치되고 shared memory를 공유함.
기본적으로 데이터는 DRAM에 저장되고 HBM이나 GDDR로 구성됨. 캐시는 L2 캐시와 L1 캐시로 나뉘어 지는데 L2 캐시는 모든 코어와 SM이 접근 할 수 있으며 DRAM의 캐시 역할을 함. L1 캐시는 한 SM 내부에서만 공유 가능한 캐시 역할을 함. (최신 아키텍쳐에서는 인접한 SM과 공유가 가능한것으로 알고 있긴 함) L1 캐시는 특히 shared memory라고 하는 개발자가 수동으로 제어할 수 있는 영역과 물리적으로 동일한 공간을 나눠씀.
jax.jit -> StableHLO -(XLA)-> HLO -(XLA)-> LLO -> VLIW bundle(machine code) -> TPU IMEM